Perbandingan Antara QPCR Dan RNA‑seq Mendedahkan Cabaran Mengukur Ungkapan HLA Bahagian 2
May 25, 2023
Normalisasi
Kami menggunakan anggaran ungkapan dalam transkrip per juta (TPM), iaitu normalisasi standard yang dihasilkan oleh Salmon dan sepadan dengan jumlah relatif transkrip yang diberikan dalam sampel. Untuk mana-mana gen tertentu, anggaran itu hanyalah jumlah TPM untuk transkripnya. Dalam sesetengah kes apabila kami menunjukkan anggaran berubah normal piawai, kami melakukan transformasi normal kedudukan data RNAseq menggunakan pakej GenABEL R (Aulchenko et al. 2007), yang biasanya digunakan, contohnya, dalam model linear pemetaan eQTL (Delaneau et al. 2017).
Pemetaan QTL ialah kaedah untuk mengkaji mekanisme pengawalseliaan ekspresi gen dengan membandingkan perkaitan antara ekspresi gen dan polimorfisme gen dalam populasi. Model linear ialah kaedah pemetaan eQTL yang biasa digunakan, yang boleh menggunakan model regresi linear untuk menganggarkan korelasi antara ekspresi gen dan polimorfisme gen.
Sistem imun ialah sistem biologi kompleks yang melindungi tubuh daripada jangkitan dan penyakit seperti kanser. Pengawalseliaan ekspresi gen memainkan peranan penting dalam sistem imun dan boleh menjejaskan perkembangan, pembezaan, dan fungsi sel imun.
Oleh itu, model linear pemetaan eQTL boleh digunakan untuk menganalisis hubungan antara mekanisme pengawalseliaan ekspresi gen dan imuniti. Sebagai contoh, mengkaji korelasi antara genotip tertentu dan ekspresi gen imun utama dalam populasi boleh mendedahkan pengaruh genotip ini dalam mengawal selia ekspresi gen imun. Penyelidikan sedemikian boleh memberi pencerahan penting untuk rawatan dan pencegahan penyakit imun. Ini menunjukkan kepentingan imuniti, jadi kita perlu meningkatkan imuniti kita setiap hari. Daging cincang juga mempunyai kesan anti-virus, anti-kanser, dan lain-lain, yang boleh menguatkan imuniti Keupayaan sistem untuk menentang dan meningkatkan imuniti badan.
Klik manfaat kesihatan cistanche
Baca penjajaran kepada genom rujukan
Untuk analisis liputan bacaan pada gen HLA yang dilaporkan dalam Rajah S7, kami menyelaraskan bacaan kepada genom rujukan GRCh38 dengan STAR v2.7.3a (Dobin et al. 2013), menggunakan anotasi gen Gencode v37. Untuk mengawal bias pemetaan pada gen HLA, kami selanjutnya memproses fail BAM dengan hlamapper v4.3 (Castelli et al. 2018).
Simulasi
Data kebenaran asas
Untuk menjana data simulasi, kami mula-mula menjalankan Salmon v1.3.0 (Patro et al. 2017) pada sampel sebenar #66K00003 untuk mempelajari tahap ekspresi transkrip Gencode v37. Kemudian kami menggunakan pakej Poliester (v1.26.0) untuk menjana 50 sampel sintetik dengan tahap ekspresi lebar transkrip yang sama, kecuali untuk HLA-A, -B dan -C. Tahap ekspresi untuk gen ini adalah berdasarkan 50 individu yang dipilih secara rawak daripada data sebenar kami (yang mana kami mempunyai data alel HLA yang tersedia). Bagi setiap gen HLA, kami memilih isoform yang menyumbang sekurang-kurangnya 90 peratus daripada jumlah ekspresi transkrip pengekodan protein dalam Salmon yang dijalankan pada dataset sebenar (yang menghasilkan hanya 1 transkrip setiap gen) dan memperibadikan urutan transkrip mengikut Alel HLA dibawa oleh setiap individu.
Prosedur ini membolehkan kami menjana 50 individu secara sintetik dengan tahap ekspresi latar belakang yang sama, tetapi dengan ekspresi HLA berubah-ubah dan dengan polimorfisme HLA terbina dalam bacaan simulasi.
Untuk mencerminkan data sebenar kami, tiga puluh juta bacaan akhir berpasangan 126 bp dengan saiz serpihan min 261 bp telah disimulasikan untuk setiap individu, menggunakan lalai untuk parameter poliester lain (cth, sisihan piawai bagi panjang serpihan=25 bp, kadar ralat=0.005, pengedaran seragam bacaan dan tiada berat sebelah). Poliester mengeluarkan fail FASTA, dari mana kami menghasilkan fail FASTQ dengan skor kualiti yang berterusan (simbol sepadan "F").
Metrik untuk ketepatan
TPM dikira pada kiraan simulasi memandangkan panjang transkrip dan saiz serpihan purata 261 bp. Nisbah "Anggaran TPM/TPM Sebenar" digunakan untuk menilai prestasi dalam memulihkan tahap ekspresi simulasi dan membolehkan kami memerhatikan ke bawah atau terlalu tinggi.
Grafik
Kami menyediakan semua plot dalam artikel ini menggunakan pakej ggplot2 v3.3.2 (Wickham 2016) dalam R.

Keputusan
Ketepatan pengiraan HLA RNA‑seq
Memandangkan ketiadaan kaedah yang boleh dianggap sebagai standard emas eksperimen untuk kuantifikasi ekspresi HLA daripada data RNA-seq, kami pada mulanya menilai ketepatan kaedah kuantifikasi RNA-seq untuk HLA menggunakan data simulasi di mana tahap ekspresi sebenar diketahui sejak ia dijana. dalam komputer untuk meniru eksperimen sebenar. Ini dilakukan untuk memilih pendekatan pengiraan terbaik antara kaedah berasaskan RNA-seq, membenarkan kontras seterusnya dengan pendekatan bukan-RNA-seq.
Kami mensimulasikan eksperimen RNA-seq untuk 50 individu menggunakan pakej Poliester (Frazee et al. 2015). Individu sintetik ini mempunyai tahap ekspresi yang sama untuk semua gen dalam genom, kecuali untuk HLA-A, -B, dan -C, yang mana kami mengubah tahap ekspresi. Kami juga memperibadikan jujukan transkrip HLA beranotasi daripada Gencode v37 untuk memperkenalkan variasi genetik sebenar yang diperhatikan dalam individu yang dipilih secara rawak daripada set data 96 individu (yang merupakan genotip HLA oleh penjujukan Sanger seperti yang diterangkan di bawah). Transkrip diperibadikan yang terhasil mempunyai identiti jujukan median dengan rujukan lebih daripada 95 peratus untuk semua lokus HLA.
Kami membandingkan anggaran ungkapan HLA yang diperoleh melalui dua kaedah bioinformatik: (1) "Transkriptom Ref," yang menggunakan Salmon (Patro et al. 2017) untuk menyelaraskan bacaan dengan transkrip rujukan standard, mengukur kelimpahan transkrip dan (2) "Diperibadikan," yang juga menggunakan Salmon, tetapi peta dibaca pada transkrip HLA yang diperibadikan, mencerminkan genotip HLA individu (Gamb. 1). Pendekatan "Diperibadikan" memanjangkan strategi kami sebelum ini (Aguiar et al. 2019) dengan menggunakan transkrip diperibadikan, dan bukannya satu urutan pengekodan kanonik untuk setiap alel yang dibawa oleh individu.

Kaedah "Ref transkriptom" meremehkan tahap ekspresi, khususnya untuk alel dengan nisbah jujukan yang lebih besar mengenai genom rujukan (Rajah 1). Ini dijangka memandangkan kadar ketidakpadanan yang lebih tinggi antara bacaan dan rujukan memberi kesan negatif kepada penjajaran (Brandt et al. 2015). Pendekatan ini juga melebihkan ekspresi HLA-C untuk sesetengah individu, akibat daripada bacaan daripada HLA-B dipetakan kepada transkrip rujukan HLA-C (Rajah S1). Pendekatan "Diperibadikan" pula mengawal bias pemetaan dan mencapai ketepatan yang optimum.
Walaupun simulasi kami memberikan hasil yang menggalakkan mengenai kuantifikasi ekspresi HLA menggunakan RNAseq, kami mesti mempertimbangkan beberapa kaveat. Kami mengubah suai jujukan isoform beranotasi mengikut alel HLA individu menggunakan satu set isoform untuk semua alel pada gen HLA tertentu. Urutan tersebut digunakan dalam simulasi bacaan dan juga dalam kuantifikasi ungkapan; oleh itu, kami menjangkakan ketepatan yang optimum. Dalam senario sebenar, alel HLA yang berbeza mungkin dikaitkan dengan isoform yang berbeza. Kemudian dalam kertas ini, kita membincangkan contoh khusus yang kita perhatikan untuk HLA-A, selaras dengan hipotesis bahawa isoform tertentu adalah eksklusif untuk alel tertentu. Walau bagaimanapun, memandangkan kami amat berminat dengan anggaran ekspresi peringkat gen dan tahap alel HLA, kami menjangkakan jujukan yang diperibadikan mewakili peningkatan ke atas satu transkrip rujukan dengan mengurangkan bias pemetaan.
Menganggarkan ungkapan HLA daripada data RNA‑seq sebenar
Kami melakukan anggaran ekspresi pada data RNA-seq keseluruhan transkrip untuk 96 individu, yang mana qPCR untuk tahap ekspresi permukaan HLAA, -B, dan -C, dan HLA-C dianggarkan sebelum ini (Kulkarni et al. 2013; Ramsuran et al. 2015, 2017), dan boleh digunakan untuk membandingkan dengan keputusan RNAseq (lihat Rajah S2 untuk analisis QC pada data RNA-seq).
Memandangkan ketepatan pendekatan diperibadikan yang lebih tinggi dalam simulasi, kami membezakan kaedah anggaran ekspresi berasaskan RNA-seq ini dengan pendekatan bukan-RNA-seq yang lain, tetapi memberikan keputusan untuk pendekatan berasaskan transkriptom rujukan dalam "Maklumat tambahan. " Kami memperibadikan urutan transkrip yang diberikan genotip HLA individu yang diperolehi oleh penjujukan Sanger. Kami menjalankan HLApers (Aguiar et al. 2019) dan Kourami (Lee dan Kingsford 2018) untuk membuat kesimpulan alel terus daripada data RNA-seq dan mengesahkan panggilan Sanger (lihat "Bahan dan kaedah").
Anggaran ekspresi peringkat gen menunjukkan bahawa HLA-B mempunyai ekspresi tertinggi di kalangan lokus HLA dalam dataset kami, diikuti oleh HLA-C dan HLA-A (Rajah 2A). Penyusunan ini konsisten dengan set data keseluruhan darah GTEx (GTEx Consortium 2020) dan dengan kaedah RNAseq tangkapan HLA sebelum ini yang digunakan pada PBMC (Yamamoto et al. 2020). Walau bagaimanapun, corak ini berbeza daripada yang dilihat oleh Boegel et al (2018), yang memerhati tahap yang sama merentas gen menggunakan strategi yang berbeza untuk menangani pemetaan bacaan ke pelbagai lokus, yang mungkin menyumbang kepada kekurangan perbezaan merentas lokus dari segi tahap ekspresi. ). Kajian masa depan perlu membezakan sumbangan perbezaan dalam metodologi atau komposisi jenis sel kepada perbezaan ini.

Membandingkan RNA‑seq dan qPCR pada data sebenar
Kami seterusnya membandingkan anggaran ekspresi RNA-seq kepada yang diperoleh dengan qPCR (Rajah 2B). Walaupun korelasi antara ekspresi RNA-seq dan qPCR adalah signifikan secara statistik untuk semua gen (p=0.024, 0.002, 0.000000016, untuk HLA-A, -B, dan -C, masing-masing; ujian Spearman untuk persatuan positif), magnitud korelasi adalah sederhana untuk HLA-A dan -B, dan lebih tinggi untuk -C. Penggunaan rujukan diperibadikan untuk RNA-seq secara sederhana meningkatkan korelasi dengan qPCR berbanding rujukan standard (Rajah S3). Ini bersetuju dengan pemerhatian kami sebelum ini bahawa anggaran ekspresi peringkat gen tidak jauh berbeza antara pendekatan berasaskan genom rujukan atau diperibadikan untuk gen kelas I HLA (Aguiar et al. 2019), dengan faedah utama pendekatan diperibadikan ialah anggaran pada Tahap alel HLA, yang kami terokai di bawah. Penggunaan pembetulan pincang dalam Salmon (pincang GC, pincang khusus jujukan dan pincang khusus kedudukan) meningkatkan korelasi dengan qPCR, dengan impak tertinggi untuk HLA-B (bandingkan Rajah 2B dan S4, untuk data yang diperbetulkan dan tidak diperbetulkan, masing-masing).

Membandingkan tahap mRNA dengan ekspresi permukaan
Oleh kerana ekspresi RNA adalah bermaklumat tentang langkah awal isyarat sel dan tindak balas kepada rangsangan, menganalisis hubungannya dengan fenotip molekul hiliran (seperti ekspresi protein pada permukaan sel) boleh membantu kita memahami peranan peraturan pasca transkrip dan pasca translasi pada Ekspresi HLA. Perbezaan antara kelimpahan RNA dan protein dijangka kerana ia tertakluk kepada mod peraturan yang berbeza. Kesan teknikal juga boleh memperkenalkan perbezaan kerana teknik RNA dan protein berbeza dan dipengaruhi oleh jenis ralat yang tidak berkorelasi (Li dan Biggin 2015; Kaur et al. 2017; Carey et al. 2019). Tambahan pula, dalam kes kajian kami, ekspresi gen diukur pada jumlah PBMC, manakala ekspresi protein diukur pada sel CD3 ditambah yang disusun. Dengan perbezaan ini dalam fikiran, kami mengukur sejauh mana protein HLA pada permukaan sel boleh diramalkan oleh ekspresi mRNA. Analisis ini dilakukan secara eksklusif untuk HLA-C kerana ia adalah satu-satunya lokus yang antibodi yang boleh mengikat semua alel dengan pertalian yang sama tersedia. Menariknya, terdapat korelasi yang tinggi antara mRNA dan ekspresi protein untuk HLAC, dengan korelasi yang lebih tinggi sedikit untuk RNA-seq (Rajah 2C).
Ekspresi tahap alel HLA
Gen HLA mempunyai unsur kawal selia yang dikaitkan dengan transkripsi konstitutif dan transkripsi yang diaktifkan secara dinamik (René et al. 2016). Akibatnya, ekspresi HLA berbeza-beza merentas tisu dan boleh dimodulasi oleh rangkaian kawal selia yang dicetuskan oleh rangsangan yang berbeza (Anderson 2018; Carey et al. 2019). Terdapat peningkatan minat untuk memahami sama ada alel HLA yang berbeza dikaitkan dengan tahap ekspresi basal yang berbeza dan program pengawalseliaan (Aguiar et al. 2019; Gutierrez-Arcelus et al. 2020), dan sama ada variasi ini menyumbang kepada fenotip penyakit atau hasil pemindahan (Petersdorf et al. al. 2014, 2015; René et al. 2016; Bettens et al. 2022; Johansson et al. 2022). Oleh itu, anggaran ekspresi tahap alel HLA untuk qPCR dan RNA-seq telah dibandingkan. Oleh kerana alel individu selalunya agak jarang berlaku dalam set data, kami mengumpulkannya mengikut garis keturunan alel (iaitu, kumpulan alel yang ditakrifkan secara filogenetik oleh hubungan ekson) (Elsner et al. 2002).
Kami meletakkan garis keturunan mengikut tahap ekspresi mereka berdasarkan kedua-dua data RNA-seq dan qPCR dan menilai kesesuaian kedudukan merentas kaedah (Rajah 3). Pendekatan RNA-seq diperibadikan kami secara langsung memberikan anggaran peringkat alel, memandangkan jujukan alel HLA digunakan untuk mengindeks penjajaran, jadi kami memesan garis keturunan alel mengikut tahap ekspresi mediannya. Oleh kerana anggaran ekspresi qPCR kami berada pada tahap gen dan tidak memberikan anggaran peringkat alel secara langsung, kami memesan garis keturunan alel mengikut kesannya dalam model linear tahap ekspresi yang dijelaskan oleh genotip HLA (lihat Ramsuran et al. 2015). Dalam Rajah 3, nilai ungkapan diplot dua kali untuk setiap peringkat bagi setiap alel individu, dan untuk qPCR, ia hanyalah ungkapan peringkat gen yang diplot dua kali, mencerminkan kehadiran dua alel.

Susunan anggaran ungkapan adalah lebih serupa antara RNA-seq dan qPCR untuk HLA-C berbanding untuk -A dan -B (purata perbezaan susunan mutlak, di mana perbezaan tertib merujuk kepada perbezaan yang diperhatikan dalam kedudukan dalam susunan nilai ekspresi terperingkat. , antara kuantifikasi RNA-seq dan qPCR, sebanyak 2.3 untuk HLA-C, 3.1 untuk -A, dan 3.9 untuk -B), mengikut corak perjanjian yang serupa dengan ekspresi peringkat gen, yang mana kami dapati korelasi tertinggi antara RNA-seq dan qPCR untuk HLA-C.
Antara keturunan yang mempunyai perbezaan terbesar antara RNA-seq dan qPCR ialah A*11. Kami mengukur ekspresi permukaan pada subset heterozigot untuk A * 03 atau A * 11 menggunakan antibodi yang mempunyai pertalian yang sama untuk kedua-dua garis keturunan dan memerhatikan bahawa qPCR berkorelasi lebih teguh dengan ekspresi permukaan sel kedua-dua allotype ini daripada RNA-seq (Rajah 1). S5). Seterusnya, kami membentangkan penilaian yang lebih luas terhadap pesanan alel melalui perbandingan dengan kajian sebelumnya mengenai ekspresi mRNA HLA.
Walaupun terdapat minat untuk membandingkan perbezaan ekspresi antara alel HLA, pelbagai kajian menunjukkan bahawa variasi dalam ekspresi dalam alel atau garis keturunan alel selalunya agak tinggi, dan perbezaan antara alel yang berlainan pangkat selalunya kecil dan tidak ketara. Akibatnya, mungkin tidak realistik untuk mengharapkan pengekalan peringkat merentas berbilang alel, dan mungkin lebih baik untuk membandingkan anggaran ungkapan untuk alel pada ungkapan yang melampau.
Untuk data RNA-seq kami, kami membandingkan anggaran kami dengan dua pendekatan RNA-seq yang disesuaikan dengan HLA sebelumnya pada PBMC. Terdapat keselarasan yang baik secara keseluruhan dengan Yamamoto et al. (2020), di mana A*24, A*02, C*04 dan C*06 sangat dinyatakan, dan A*03, C*03 dan B*15 dinyatakan pada tahap rendah, walaupun kita juga melihat perbezaan seperti bagi B*35, yang lebih bersetuju dengan data qPCR kami. Apabila kami membandingkan data RNA-seq kami dengan Johansson et al. (2021), bagaimanapun, kita melihat lebih banyak perbezaan, walaupun mereka mempunyai sampel yang sangat kecil untuk banyak keturunan.
Kami juga membezakan keputusan kami dengan hasil daripada dua kajian qPCR sebelumnya yang menggunakan primer khusus alel. Bettens et al. (2014) menggunakan primer khusus alel untuk beberapa keturunan HLAC dan melihat C * 04 dan C * 06 sebagai sangat dinyatakan, manakala C * 07 dan C * 03 dinyatakan pada tahap rendah, selaras dengan apa yang kita ada untuk kedua-dua RNA-seq dan qPCR. René et al. (2015) menggunakan primer khusus alel untuk HLA-A, dan memerhatikan A*02 (tinggi) dan A*29 (rendah) pada ungkapan yang melampau, yang lebih bersetuju dengan keputusan RNAseq kami daripada qPCR kami; walau bagaimanapun, kita melihat banyak perbezaan pada keturunan alel yang lain
Dalam sesetengah kes, kami juga boleh menilai persetujuan dengan kajian berfungsi. Sebagai contoh, analisis sebelumnya terhadap tapak pengikat faktor transkripsi (TFBS) dan aktiviti promoter (disemak dalam Anderson 2018), dan kajian tentang peraturan miRNA (Kulkarni et al. 2011), menunjukkan bahawa C*03 dan C*07 adalah alel yang dinyatakan dengan lemah, yang bersetuju dengan pemerhatian kami untuk kedua-dua RNA-seq dan qPCR.
Sumber yang berpotensi untuk perbezaan
Kami seterusnya menyiasat sama ada pemprosesan sampel yang digunakan untuk RNA-seq boleh menyumbang kepada perbezaan antara anggaran ekspresi yang diperolehi dengan qPCR dan RNA-seq.
Satu kebimbangan khusus ialah tempoh masa sampel disimpan dalam peti sejuk -80 darjah (kira-kira 4 tahun antara ujian qPCR dan RNA-seq), serta langkah lain yang khusus untuk eksperimen RNA-seq, termasuk pencairan sampel. Untuk menangani ini, kami melakukan eksperimen RNAseq kedua pada darah segar yang ditarik semula daripada 11 individu, yang merupakan subset daripada 96 yang dianalisis dalam kajian ini, dan kami membandingkan anggaran ungkapan antara titik dua masa. Walaupun ujian kedua ini membawa kedua-dua perbezaan teknikal dan biologi berkenaan eksperimen RNA-seq pertama (Rajah S6A dan B), korelasi luas transkriptom dalam anggaran ungkapan antara titik masa adalah tinggi (Rajah S6C).
Walaupun menilai korelasi dengan 11 individu boleh menjadi bising, korelasi pada gen HLA adalah antara korelasi gen terbesar antara kedua-dua sampel (Rajah S6D dan F). Kami juga mengira nisbah alel dalam individu, iaitu nisbah ungkapan antara dua alel HLA individu heterozigot, dan membandingkannya antara titik masa. Kolerasi adalah lebih besar daripada 0.94 untuk HLA-A, -B dan -C (Rajah S6E). Oleh itu, kami tidak melihat bukti sumbangan utama kemerosotan RNA untuk menjelaskan korelasi rendah antara RNA-seq dan qPCR dalam sampel asal kami.
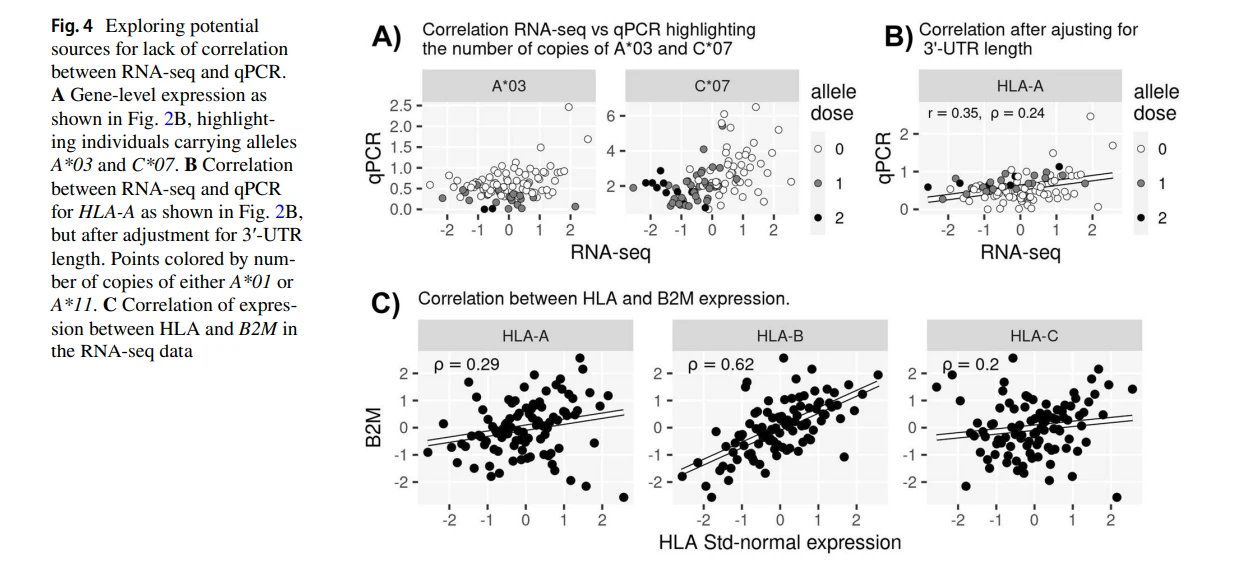
Satu lagi sumbangan yang mungkin kepada perbezaan antara RNA-seq dan qPCR ialah alel HLA tertentu mungkin lebih berat sebelah dalam satu kaedah atau yang lain, di mana individu yang membawa alel tersebut akan menyumbang kepada perbezaan yang besar. Sebagai contoh, bagi individu yang membawa A*03, atau untuk homozigot untuk C*07, terdapat hubungan negatif antara qPCR dan RNA-seq (Rajah 4A).

Sumber tambahan perbezaan antara kaedah mungkin timbul daripada fakta bahawa, dalam pendekatan RNA-seq kami, kami memperibadikan semua transkrip beranotasi Gencode untuk setiap alel HLA; bagaimanapun, kepelbagaian transkrip sebenar dan perkaitannya dengan alel HLA tertentu tidak difahami dengan baik. Sebagai contoh, Kulkarni et al. (2017) menunjukkan bahawa A*01 dan A*11 menghasilkan 3′-UTR yang lebih pendek. Untuk menyiasat sama ada kami boleh meniru pembiayaan itu dalam data RNA-seq kami, kami memetakan bacaan kepada genom rujukan dan diperbetulkan untuk pemetaan bias pada gen HLA dengan hla-mapper (Castelli et al. 2018). Sesungguhnya, bagi individu yang membawa A*01 atau A*11, liputan bacaan pada 3′-UTR HLA-A menunjukkan penurunan mendadak pada ~120 bp sebelum akhir gen beranotasi (Rajah S7).
Oleh kerana nilai transkrip setiap juta (TPM) dikira dengan mengambil kira panjang rujukan, menggunakan rujukan yang lebih panjang daripada transkrip sebenar membawa kepada penilaian yang rendah terhadap ungkapan. Kami cuba mengawal kemungkinan transkrip yang lebih pendek dengan memasukkan versi setiap transkrip HLA-A dengan 3'-UTR yang dipendekkan dalam indeks kami untuk penjajaran baca. Walau bagaimanapun, kami tidak menemui bukti ekspresi isoform yang lebih pendek (Rajah S8), mungkin kerana isoform yang lebih pendek ini terkandung dalam isoform panjang biasa, dan pelaksanaan Salmon memperuntukkan semua bacaan kepada isoform yang lebih besar. Menariknya, ungkapan pada tahap isoform mendedahkan isoform dengan 5'-UTR yang lebih panjang eksklusif kepada A*11, yang menyumbang sebahagian besar daripada jumlah ungkapan untuk alel ini (Rajah S8).
Kami juga menguji normalisasi anggaran ungkapan kami, di mana kami melaraskan panjang bacaan memandangkan liputan bacaan yang menyokong terminal 3'-UTR proksimal atau distal (purata wajaran panjang transkrip menggunakan liputan baca sebagai pemberat). Walaupun kami melihat peningkatan sehingga 20 peratus dalam tahap ekspresi untuk individu yang membawa A*01 dan/atau A*11, kami hanya melihat peningkatan kecil dalam korelasi dengan qPCR selepas pelarasan ini (dari rho=0. 20 dalam Rajah 2 hingga rho=0.24 dalam Rajah 4B).
A*01 dan A*11 adalah antara alel dengan perbezaan pangkat terbesar antara RNA-seq dan qPCR (Rajah 3), dan perwakilan yang tidak sempurna bagi transkrip berkaitannya dalam anotasi mungkin memperkenalkan berat sebelah dalam anggaran RNA-seq kami.
Akhir sekali, kaedah normalisasi yang digunakan untuk mendapatkan anggaran ekspresi akhir daripada data qPCR mentah juga boleh menjadi sumber perbezaan antara anggaran qPCR dan RNA-lihat. Ujian PCR kuantitatif untuk gen Kelas I HLA biasanya menguatkan kawasan dalam ekson 1 hingga 4, dan penyeragaman oleh ekspresi gen pengemasan seperti B2M ( 2-microglobulin) biasanya dijalankan (seperti yang berlaku dalam kajian ini. ). Rasional untuk prosedur ini ialah jika tahap ekspresi diseragamkan oleh rujukan yang dinyatakan secara stabil, anggaran untuk individu yang berbeza diletakkan pada skala yang sama, sekali gus membolehkan perbandingan merentas individu.
B2M mengekod untuk rantai cahaya dalam molekul Kelas I HLA, dan adalah munasabah bahawa gen B2M dan kelas I HLA mempunyai beberapa penyelarasan ekspresi, kerana ia berkongsi seni bina promoter yang serupa (Kobayashi dan van den Elsen 2{{1{{12} }}}12; Vijayan et al. 2019), dan boleh dikawal oleh faktor transkripsi yang dikongsi (contohnya, NLRC5/CITA mendorong ekspresi kedua-dua kelas HLA I dan B2M dalam barisan sel Jurkat (Meissner et al. 2{{20}}10). Normalisasi ekspresi gen HLA dengan nilai berkorelasi mungkin menimbulkan bias dalam anggaran qPCR kami, terutamanya untuk HLA-B, yang mana kami melihat nilai yang tinggi. korelasi dengan ungkapan B2M (Rajah 4C). Menskala pembolehubah dengan pembolehubah yang berbeza tetapi berkorelasi boleh mencetuskan gangguan dengan membawa nilai ekstrem ke tengah taburan dan mengurangkan varians; selaras dengan hipotesis ini, pekali variasi untuk data qPCR adalah 0.61 dan 0.50 untuk HLA-A dan -C, masing-masing, tetapi turun kepada 0.17 untuk HLA-B (sebagai perbandingan, CV untuk data RNA-seq ialah 0.20, 0.14, dan 0.29 untuk HLA-A, -B, dan -C , masing-masing). Walau bagaimanapun, menggunakan reka bentuk qPCR yang sama, Ramsuran et al. (2017) menormalkan ekspresi HLA-B oleh sama ada B2M, GAPDH, 18 s, dan gen b-Actin, dan memerhatikan hasil yang sangat konsisten, yang tidak menyokong kesan normalisasi B2M kepada anggaran qPCR.
Perbincangan
Anggaran yang boleh dipercayai bagi ekspresi transkrip HLA boleh menyumbang kepada soalan penyelidikan yang pelbagai, dan walaupun hasil penyakit sering diterokai dalam konteks variasi pengekodan HLA, tahap ekspresi juga mungkin menjelaskan variasi dalam hasil klinikal (disemak dalam Dendrou et al. 2018; dan dalam Johansson et al. 2022). Tahap ekspresi juga berpotensi untuk memaklumkan keputusan apabila merancang pemindahan sel stem hematopoietik; contohnya, jika padanan sempurna tidak tersedia dalam pemilihan untuk penderma alogenik, nampaknya berfaedah untuk memilih padanan yang tidak sepadan pada alel ekspresi rendah (Petersdorf et al. 2014, 2015). Anggaran yang boleh dipercayai bagi ekspresi transkrip juga boleh membantu dalam pengenalpastian eQTL yang mendasari kawalan ekspresi HLA, yang boleh disepadukan ke dalam penemuan GWAS, dengan menanyakan jika hits yang diketahui di rantau MHC bertepatan dengan eQTL untuk gen HLA (lihat, cth, Jadual S6 dalam Aguiar et al. 2019). Secara umumnya, anggaran penambahbaikan ekspresi transkrip HLA akan membantu kita memahami seni bina genetik peraturan HLA, mengenal pasti sumbangan relatif bagi varian cis-acting (iaitu, mereka yang berada dalam kejiranan gen HLA yang mereka kawal) dan varian urus niaga (yang berada dalam jarak jauh). lokasi genom, termasuk pada kromosom lain). Ini akan memberikan maklumat mengenai tahap variasi dalam ekspresi HLA ialah sifat khusus alel berbanding ciri antara individu yang bebas daripada identiti alel (lihat Bettens et al. 2022).
Teknik PCR kuantitatif telah membolehkan kami mendedahkan persatuan antara ekspresi HLA dan fenotip penyakit. Baru-baru ini, RNA-seq telah menjadi kaedah pilihan untuk menilai ekspresi gen dalam set data transkrip keseluruhan besar populasi yang berbeza. Keupayaan untuk mengekstrak maklumat yang tepat untuk ekspresi HLA daripada data tersebut merupakan satu cabaran yang penting, dan banyak kaedah telah dicadangkan untuk mencapai matlamat ini. Walau bagaimanapun, sejauh mana keputusan yang muncul daripada analisis RNA-seq bersetuju dengan yang terkumpul oleh penggunaan qPCR pada masa ini tidak diketahui. Walaupun kaedah ini menyasarkan fenotip molekul yang sama (kelimpahan RNA), ia berbeza dengan ketara dalam teknik eksperimen yang digunakan, bentuk menganalisis dan menormalkan data, prosedur bioinformatik, dan bias yang tertakluk kepadanya.
Untuk pengetahuan kami, kajian terdahulu yang membandingkan pendekatan RNA-seq HLAtailored dengan qPCR termasuk sampel kecil. Sebagai contoh, Johansson et al. (2021) mengesahkan RNA-seq sasaran HLA mereka dengan qPCR pada hanya 5 sampel di HLA-C, membiayai pekali korelasi Pearson sebanyak 0.9, yang tidak signifikan (p=0.08) .
Dalam kajian ini, kami membandingkan anggaran ekspresi PCR dan RNA-seq kuantitatif untuk gen HLA kelas I klasik HLA-A, -B, dan -C dalam set sepadan 96 individu. Kami mendapati korelasi sederhana tetapi ketara dalam ekspresi ke atas sampel 96 individu. Memandangkan kekurangan piawaian emas untuk membandingkan anggaran ini, ralat anggaran dan berat sebelah yang dikaitkan dengan kedua-dua kaedah boleh menyumbang kepada hasil keseluruhan.
Kami meneroka kesan pelbagai faktor yang mungkin menjelaskan korelasi rendah antara anggaran RNA-seq dan qPCR, seperti anggaran ekspresi yang lemah untuk alel HLA tertentu dan normalisasi oleh gen pengemasan tunggal dalam qPCR. Keputusan kami tidak boleh digeneralisasikan kepada setiap reka bentuk qPCR atau saluran paip RNA-seq, yang mana terdapat pelbagai jenis pendekatan yang berbeza. Walau bagaimanapun, untuk pengetahuan kami, ini adalah perbandingan langsung pertama antara qPCR dan RNA-seq untuk anggaran ekspresi HLA.
Kajian kami mencadangkan kawasan yang memerlukan penambahbaikan dalam penentuan ekspresi transkrip HLA. Perbandingan antara RNA-seq dan qPCR, sebagai contoh, harus menggunakan pemprosesan seragam sampel merentas kaedah (cth, protokol pengasingan RNA yang sama, masa penyimpanan/pencairan, integriti RNA) untuk mengehadkan perbezaan artifak yang dikaitkan dengan kaedah ini. Pemetaan bacaan pendek kepada genom rujukan tunggal atau transkriptom menjana bias, dan strategi yang memetakan bacaan perakaunan untuk polimorfisme HLA adalah perlu. Memandangkan terdapat beberapa strategi untuk mencapai ini (Boegel et al. 2012; Lee et al. 2018; Aguiar et al. 2019; Gutierrez-Arcelus et al. 2020; Darby et al. 2020), ia akan menjadi kunci untuk membandingkan ketepatan relatif pendekatan ini.
Terdapat juga keperluan untuk membangunkan kaedah yang mengambil kira variasi isoform secukupnya, bukan sahaja untuk menyediakan satu lagi lapisan maklumat tetapi juga anggaran ungkapan yang lebih tepat, memandangkan penormalan kiraan bacaan oleh panjang transkrip yang salah merupakan sumber ralat yang berpotensi. Dalam konteks ini, data yang dibaca lama, yang secara langsung menjana maklumat transkrip penuh, boleh menjadi alat yang berkuasa (Cornaby et al. 2022). Akhir sekali, variasi nombor salinan, ciri yang diketahui untuk lokus HLA tertentu (cth, DRB), juga harus dipertimbangkan semasa mengira tahap ekspresi.
Ucapan terima kasih
Kami mengucapkan terima kasih kepada Tatiana Torres (Universiti São Paulo), Yang Luo (Sekolah Perubatan Harvard), dan ahli-ahli Konsortium Biologi Bersama di Boston, atas perbincangan mereka yang berguna.
Sumbangan pengarang
Diogo Meyer, Mary Carrington, Richard M. Single, dan Vitor RC Aguiar menyumbang kepada konsep dan reka bentuk kajian. Penyediaan bahan, pengumpulan data dan eksperimen dilakukan oleh Maureen P. Martin, Veron Ramsuran, Smita Kulkarni, Arman Bashirova, Danillo G. Augusto, dan Mary Carrington. Analisis data dilakukan oleh Vitor RC Aguiar, Erick Castelli, Richard M. Single, Maria Gutierrez-Arcelus, dan Diogo Meyer. Manuskrip itu ditulis oleh Vitor RC Aguiar dan Diogo Meyer. Semua pengarang membaca, membuat sumbangan, dan meluluskan manuskrip akhir.
Pembiayaan
Agensi Pembiayaan São Paulo (FAPESP, http://www.fapesp. br/en/) menyediakan pembiayaan kepada DM (2012/18010-0 dan 2013/22007-7) dan kepada VRCA (2014/{{ 5}} dan 2016/24734-1). Institut Kesihatan Nasional, Amerika Syarikat menyediakan pembiayaan kepada DM (NIH R01 GM075091), yang menyokong sebahagian daripada postdoc VRCA. Conselho Nacional de Desenvolvimento Científco e Tecnológico (CNPq) & Kementerian Kesihatan, Brazil menyediakan pembiayaan untuk eksperimen RNA-seq dan lawatan perjalanan penyelidikan, sebagai sebahagian daripada cadangan bersama AS-Brazil yang diberikan kepada MC dan DM (470043/{{13} }). NIH/NIAID R01AI157850 menyokong SK. VR dibiayai oleh Majlis Penyelidikan Perubatan Afrika Selatan (SAMRC) dengan dana daripada Jabatan Sains dan Teknologi (DST); dan turut disokong sebahagiannya melalui Rangkaian Afrika Sub-Sahara untuk Kecemerlangan Penyelidikan TB/HIV (SANTHE), Inisiatif DELTAS Afrika (Geran # DEL-15-006) oleh AAS.
Projek ini telah dibiayai secara keseluruhan atau sebahagiannya dengan dana persekutuan daripada Frederick National Laboratory for Cancer Research, di bawah Kontrak No. HHSN261200800001E. Kandungan penerbitan ini tidak semestinya menggambarkan pandangan atau dasar Jabatan Kesihatan dan Perkhidmatan Manusia, mahupun menyebut nama dagangan, produk komersial atau organisasi membayangkan sokongan oleh Kerajaan AS. Penyelidikan ini sebahagiannya disokong oleh Program Penyelidikan Intramural NIH, Makmal Kebangsaan Frederick, Pusat Penyelidikan Kanser.
Ketersediaan data
Data RNA-seq yang dibentangkan dalam penerbitan semasa telah disimpan dan tersedia daripada pangkalan data dbGaP di bawah penyertaan dbGaP phs003177.v1.p1.
Rujukan
1. Aguiar VRC, César J, Delaneau O, et al (2019) Anggaran ekspresi dan pemetaan eQTL untuk gen HLA dengan saluran paip yang diperibadikan. PLoS Genet 15:e1008091.
2. Alcina A, Abad-Grau MDM, Fedetz M et al (2012) Varian risiko sklerosis berbilang HLA-DRB1*1501 dikaitkan dengan ekspresi tinggi gen DRB1 dalam populasi manusia yang berbeza. PLoS One 7:e29819.
3. Anderson SK (2018) Evolusi molekul unsur yang mengawal ekspresi HLA-C: Penyesuaian kepada peranan sebagai ligan reseptor seperti imunoglobulin sel pembunuh yang mengawal selia fungsi sel pembunuh semulajadi. HLA 92:271–278.
4. Apps R, Meng Z, Del Prete GQ et al (2015) Tahap ekspresi relatif bagi protein kelas-I HLA dalam sel normal dan dijangkiti HIV. J Immunol 194:3594–3600.
5. Apps R, Qi Y, Carlson JM, et al (2013) Pengaruh tahap ekspresi HLA-C terhadap kawalan HIV. Sains 340:87–91.
6. Arshad N, Laurent-Rolle M, Ahmed WS et al (2023) Protein aksesori SARS-CoV-2 ORF7a dan ORF3a menggunakan mekanisme yang berbeza untuk mengawal selia ekspresi permukaan MHC-I. Proc Natl Acad Sci USA 120:e2208525120.
7. Aulchenko YS, Ripke S, Isaacs A, van Duijn CM (2007) GenABEL: perpustakaan R untuk analisis persatuan seluruh genom. Bioinformatik 23:1294–1296.
8. Bachtel ND, Umviligihozo G, Pickering S, et al (2018) HLA-C downregulation oleh HIV-1 menyesuaikan diri dengan genotip HLA hos. PLoS Pathog 14:e1007257.
9. Bettens F, Brunet L, Tiercy JM (2014) Kebolehubahan alel tinggi dalam ekspresi mRNA HLA-C: perkaitan dengan haplotaip lanjutan HLA. Gen Imun 15:176–181.
10. Bettens F, Ongen H, Rey G et al (2022) Peraturan ekspresi kelas I HLA oleh variasi gen bukan pengekodan. PLoS Genet 18:e1010212
11.Boegel S, Bukur T, Castle JC, Sahin U (2018) Dalam Penaipan Siliko Alel HLA Klasik dan Bukan Klasik daripada Bacaan RNA-Seq Standard. Kaedah Mol Biol 1802:177–191.
For more information:1950477648nn@gmail.com