Adakah Ujian Meningkatkan Pembelajaran Baharu Kerana Ia Melindungi Terhadap Gangguan Proaktif?(2)
Jun 08, 2023
Eksperimen 3
Matlamat Eksperimen 3 adalah untuk meniru Eksperimen 2 dengan setia oleh Nunes dan Weinstein (2012). Untuk tujuan ini, kami menghubungi pengarang utama kajian itu dan mengesahkan bahawa bahan dan prosedur kami mewakili replikasi langsung kajian mereka yang setia (Nunes, komunikasi peribadi, 2020). Terdapat empat perbezaan ketara antara Eksperimen 3 dan Eksperimen 1 dan 2. Pertama, peserta mempelajari perkataan DRM dan bukannya perkataan yang dikategorikan. Kedua, peserta mempelajari 12 perkataan setiap senarai dan bukannya 16 perkataan setiap senarai. Ketiga, setiap perkataan ditunjukkan selama 2 s dan hanya sekali (dalam Eksperimen 1 dan 2 kami, peserta mengkaji setiap perkataan dua kali pada 4 s setiap satu). Akhir sekali, peserta dalam keadaan kawalan menyelesaikan masalah matematik dan bukannya mengkaji semula senarai.
ginseng padang pasir
Kaedah
Reka bentuk dan peserta
Mencerminkan Nunes dan Weinstein (2012), Eksperimen 3 menggunakan reka bentuk satu faktor, dua peringkat (iaitu, ujian lwn. tiada ujian), dengan faktor ini dimanipulasi antara subjek. Seramai 71 pelajar sarjana muda dari Iowa State University mengambil bahagian untuk kredit kursus. Data daripada empat peserta tidak dianalisis - dua kerana mereka tidak mengikut arahan dan dua kerana ralat penguji. Sampel akhir itu termasuk data daripada 67 peserta, dengan 36 dalam keadaan ujian dan 31 dalam keadaan tanpa ujian. Analisis kuasa sensitiviti menunjukkan bahawa saiz sampel ini mempunyai kuasa .80 untuk mengesan saiz kesan d=0.70.
Cistanche deserticola
Bahan dan prosedur
Bahan dan prosedur adalah sama seperti Nunes dan Weinstein (2012), Eksperimen 2). Empat senarai DRM (gunung, lembut, sungai dan bandar) daripada Stadler et al. (1999) norma digunakan sebagai bahan kajian. Senarai 1–4 mengandungi 12 perkataan daripada satu tema DRM. Perkataan dalam kedudukan ketiga, kelima dan ke-13 bagi setiap tema DRM dalam norma Stadler hanya dibentangkan dalam Senarai sasaran 5. Empat pengimbang yang berbeza telah digunakan, supaya sesetengah peserta mengkaji senarai lembut sebagai Senarai 1 dan yang lain mengkajinya sebagai mereka. Senarai 2, 3, atau 4. Walau bagaimanapun, susunan perkataan dalam setiap senarai telah ditetapkan dan dibentangkan dalam susunan yang sama seperti yang terdapat dalam Stadler et al. norma (iaitu, bukit selalu dibentangkan dahulu, lembah, kemudian tunduk, dsb.). Ambil perhatian bahawa skim pengimbangan balas hanya mempengaruhi perkataan dalam Senarai 1–4; perkataan yang dipilih untuk Senarai 5 tidak diimbangi, sehingga perkataan ini tidak pernah muncul dalam Senarai 1–4 untuk mana-mana peserta. Senarai 5 mempersembahkan tiga perkataan yang tidak dipelajari sebelum ini daripada setiap tema DRM yang dikaji dalam susunan rawak yang berbeza untuk setiap peserta, tetapi semua peserta mengkaji perkataan yang sama dalam Senarai 5.
Semua perkataan dibentangkan selama 2 saat setiap satu dengan 500-ms selang antara rangsangan. Selepas setiap senarai, peserta menyelesaikan sepuluh masalah matematik pada 6 saat setiap satu. Kemudian, peserta dalam keadaan ujian mempunyai 60 saat untuk mengingat perkataan daripada senarai yang baru dipelajari, manakala mereka yang dalam keadaan tanpa ujian menyelesaikan masalah matematik tambahan selama 60 saat lagi. Selepas mempelajari Senarai 5, semua peserta menyelesaikan masalah matematik selama 60 saat dan kemudian mengambil ujian ingat semula. Mereka kemudiannya menyelesaikan 5-ujian ingat semula kumulatif min. Ujian kumulatif dijalankan sebagai sebahagian daripada replikasi, tetapi data daripada ujian ini tidak menarik dan oleh itu tidak mendapat markah.
Percubaan Cistanche deserticola
Keputusan
Pencerobohan semasa memanggil semula Senarai 5
Dalam Eksperimen 1 dan 2, kami menggunakan kekerapan untuk melaporkan data pencerobohan, yang merupakan metrik utama dalam literatur (Chan, Manley, et al., 2018; Weinstein et al., 2014). Tetapi di sini, kami melaporkan pencerobohan menggunakan kekerapan serta perkadaran kerana yang terakhir digunakan untuk membentangkan pencerobohan dalam Nunes dan Weinstein (2012). Secara khusus, mereka membahagikan kekerapan pencerobohan sebanyak 60, iaitu bilangan perkataan kajian merentas kelima-lima senarai. Selaras dengan Nunes dan Weinstein, kami tidak mengira ingatan palsu perkataan DRM kritikal sebagai pencerobohan. Sebaliknya, kata-kata ini dijaringkan secara berasingan sebagai pengingat palsu yang kritikal.
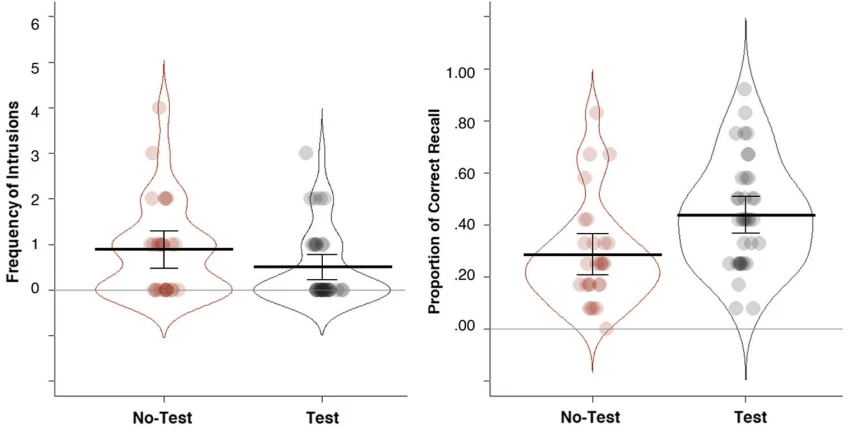
Rajah 6 Kekerapan pencerobohan semasa ingat semula Senarai 5 (kiri) dan perkadaran ingat semula betul Senarai 5 (kanan) sebagai fungsi tugas campur tangan dan tahap PI dalam Eksperimen 3. Bar ralat memaparkan deskriptif .95 selang keyakinan. Jitter diperkenalkan untuk menyebarkan titik data secara mendatar untuk meningkatkan keterlihatan
Potongan terpencil untuk pencerobohan ialah 4.03 item (M=0.97, SD=1.53), yang mengecualikan data daripada empat peserta. Panel kiri Rajah 6 menunjukkan kekerapan pencerobohan semasa memanggil semula Senarai 5. Menariknya, tidak seperti keputusan dalam Eksperimen 1 dan 2, tiada perbezaan yang ketara dalam pencerobohan antara peserta yang diuji (M=0.50, M=.01 dalam perkadaran) dan peserta yang tidak diuji (M { {15}}.89, M=.02 dalam perkadaran), t(61)=1.66, p=.102, d=0.42, B 01=1.22. Data ini adalah setanding dengan penemuan Nunes dan Weinstein (2012), yang mendapati tiada kesan ketara aktiviti campur tangan terhadap pencerobohan. Menariknya, apabila kami meneliti data pencerobohan dengan pencerobohan disertakan, ujian interpolasi telah mengurangkan pencerobohan dengan ketara (d=0.72, lihat OSM untuk butiran), sekali gus mereplikasi corak yang dilaporkan dalam Eksperimen 1 dan 2.
Mengikuti Nunes dan Weinstein (2012), kadar panggil balik palsu kritikal dilaporkan sebagai perkadaran (dengan kekerapan panggil balik palsu kritikal dibahagikan dengan 4 kerana terdapat empat tema DRM). Sama seperti keputusan Nunes dan Weinstein (Mtest=0.04, Mno-test=0.06), kadar ingatan semula perkataan kritikal tidak berbeza dengan ketara antara keadaan ujian dan tanpa ujian (Mtest {{ 8}}.08, M tiada ujian=0.15), t(61)=0.70, p=.489, d=0.18 B{ {20}}.14.
Senaraikan 5 ingatan yang betul
Keputusan yang paling penting dibentangkan dalam panel kanan Rajah 6. Sama seperti Eksperimen 1 dan 2 kami tetapi berbeza dengan Nunes dan Weinstein (2012), kami melihat kesan ujian ke hadapan yang teguh pada Senarai 5 betul ingat, t(61)=2.93, p=.005, d=0.75, B10=8.39 (Mtest=.44, Mno-ujian=.29). Dapatan ini konsisten dengan apa yang kami laporkan dalam Eksperimen 1 dan 2, tetapi berbeza daripada Nunes dan Weinstein (2012), yang tidak menemui kesan ujian hadapan (d ≈ 0, Mtest=.46, Mno-test {{26) }} .46). Selain itu, mereplikasi hasil Eksperimen 1 dan 2 kami, korelasi negatif antara pencerobohan dan ingatan yang betul telah diperhatikan (lihat Rajah 7), r(61)=-.35, p=.005, B 10=7.32. Tidak seperti Eksperimen 1 dan 2, korelasi telah disumbangkan oleh peserta dalam kedua-dua keadaan ujian, r(34)=-.34, p=.042, B01=1.51 dan keadaan tanpa ujian, r(25)=-.27, p=.176, B01=1.75. Kami percaya bahawa korelasi yang tidak signifikan dalam keadaan tanpa ujian mungkin disebabkan oleh kuasa yang tidak mencukupi.
Perbincangan
Keputusan dalam Eksperimen 3 sebahagian besarnya menyerupai hasil daripada Eksperimen 1 dan 2 kami – iaitu, ujian interpolasi memudahkan pembelajaran baharu walaupun peserta mempelajari perkataan dalam persekitaran yang bertujuan untuk meminimumkan pembentukan PI. Dapatan ini berbeza secara langsung dengan yang dilaporkan oleh Nunes dan Weinstein (2012) dan amat menarik apabila dilihat dalam konteks usaha replikasi keseluruhan. Secara khusus, walaupun kajian kami menggunakan sampel peserta yang berbeza dan data dikumpul hampir sedekad kemudian daripada kajian asal, dalam beberapa cara, data kami mereplikasi kajian asal dengan sangat baik. Malah, kebanyakan pembolehubah bersandar, termasuk jumlah pencerobohan perkataan yang dikaji (dalam perkadaran, Mtest=.01, Mno-test=.02 dalam percubaan kami, Mtested=.01 , Mno-test=.04 dalam Nunes dan Weinstein), mengingat palsu perkataan kritikal (Mtest=.02, Mno-test=.04 dalam percubaan kami, Mtested {{19 }} .04, Mno-test=.06 dalam Nunes dan Weinstein), dan ingatan yang betul bagi perkataan yang dikaji dalam keadaan ujian (M=.44 dalam eksperimen kami, M {{26} } .46 dalam Nunes dan Weinstein), menghasilkan data yang sangat serupa dengan yang dilaporkan oleh Nunes dan Weinstein. Pengecualian tunggal ialah data panggil balik yang betul dalam keadaan tanpa ujian. Manakala peserta kami mengingati .29 daripada Senarai 5 perkataan, peserta Nunes dan Weinstein mengingati .46. Oleh kerana saiz sampel yang lebih besar bagi percubaan kami dan replikasi Eksperimen 1 dan 2, kami percaya bahawa keputusan kami mungkin memberikan anggaran yang lebih hampir bagi min populasi. Walau bagaimanapun, memandangkan berat teori keputusan ini, kami menyasarkan untuk meniru percubaan sekali lagi dalam Eksperimen 4 tetapi dengan skema pengimbangan balas penuh.
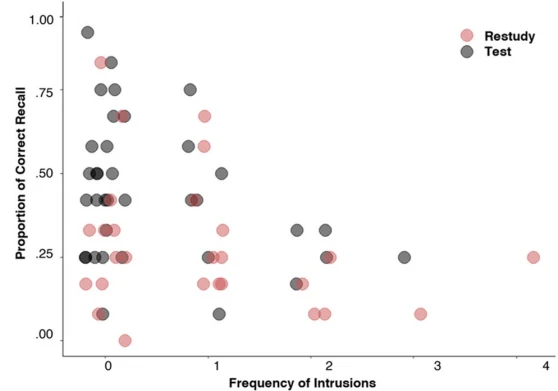
Rajah 7 Plot serakan yang memaparkan hubungan antara kekerapan pencerobohan semasa ingat semula Senarai 5 dan perkadaran ingat semula betul Senarai 5 dalam Eksperimen 3. Untuk meningkatkan keterlihatan ketumpatan data, kami memperkenalkan jitter untuk menyebarkan titik data secara mendatar
Eksperimen 4
Kaedah
Reka bentuk, peserta, bahan dan prosedur
Seramai 70 pelajar sarjana muda dari Iowa State University mengambil bahagian untuk kredit kursus. Tidak seperti Eksperimen 1–3, di mana data dikumpul di makmal kami, data daripada Eksperimen 4 dikumpulkan dalam talian kerana -19-penutupan COVID yang berkaitan dengan penyelidikan peribadi. Data daripada tiga peserta (iaitu, satu dalam keadaan ujian, dan dua dalam keadaan tanpa ujian) tidak dianalisis kerana mereka tidak mengikut arahan. Sampel akhir termasuk data daripada 67 peserta, dengan 34 dalam keadaan ujian dan 33 dalam keadaan tanpa ujian. Analisis kuasa sensitiviti menunjukkan bahawa saiz sampel ini mempunyai kuasa .80 untuk mengesan saiz kesan d=0.69.
Bahan dan prosedur adalah sama dengan yang terdapat dalam Eksperimen 3 dengan pengecualian berikut. Dalam Eksperimen 3, Senarai 5 sentiasa mengandungi perkataan yang sama. Dalam percubaan semasa, kami mengimbangi sepenuhnya tugasan perkataan kepada semua lima senarai, supaya perkataan yang muncul dalam Senarai 5 untuk seorang peserta akan muncul dalam Senarai 1, 2, 3 atau 4 untuk peserta lain. Kami membahagikan setiap set 15 perkataan tema DRM kepada lima kumpulan, dengan setiap kumpulan mempunyai kekuatan bersekutu ke belakang (BAS) yang serupa, yang menunjukkan kekuatan persatuan daripada item senarai kepada perkataan kritikal (Roediger et al., 2001). Lima kumpulan perkataan DRM digilirkan merentasi senarai peserta. Skim pengimbangan balas ini menghapuskan kemungkinan bahawa keputusan hanya akan digunakan pada perkataan DRM tertentu yang dipilih untuk ditunjukkan dalam Senarai 5 Eksperimen 3 kami dan Eksperimen 2 Nunes and Weinstein (2012). Kedua, perkataan dalam setiap senarai (dan bukan sekadar Senarai 5) dibentangkan dalam susunan rawak. Kami memilih untuk prosedur ini kerana kami ingin mengelak daripada hanya mempunyai senarai sasaran yang dibentangkan dalam susunan rawak. Kami mengesyaki bahawa Nunes dan Weinstein membentangkan senarai bukan sasaran mereka dalam susunan menurun kekuatan bersekutu kerana mereka mahu menimbulkan lebih banyak kenangan palsu, yang tidak penting untuk tujuan sekarang. Ambil perhatian bahawa walaupun perubahan ini, kami masih menganggap Eksperimen 4 sebagai replikasi langsung (Simons, 2014; Zwaan et al., 2017).

Serbuk ekstrak cistanche
Klik di sini untuk melihat produk Cistanche
【Minta lebih lanjut】 E-mel:cindy.xue@wecistanche.com / Whats App: 0086 18599088692 / Wechat: 18599088692
Keputusan
Pencerobohan semasa memanggil semula Senarai 5
Potongan terpencil untuk percubaan ini ialah 8.43 pencerobohan (M=2.01, SD=3.21), yang mengecualikan data daripada empat peserta. Seperti yang dapat dilihat pada panel kiri Rajah 8, peserta yang diuji menunjukkan lebih sedikit pencerobohan (M=0.77, M=.01 dalam perkadaran) berbanding peserta yang tidak diuji (M {{12} }.10, M=.04 dalam perkadaran), t(61)=3.56, p <.001, d=0.90, B10=40.74 . Dapatan ini konsisten dengan data kami daripada Eksperimen 1 dan 2 tetapi berbeza daripada Eksperimen 3 dan Nunes dan Weinstein (2012). Data penarikan balik palsu yang kritikal juga berbeza daripada Eksperimen 3 dan Nunes dan Weinstein. Khususnya, ujian interpolasi mengurangkan ingatan palsu kritikal (Mtest=0.03, Mno-test=0.10), t(61)=2.51, p=.015 , d=0.64, B10=3.46. Ada kemungkinan kekurangan pengimbangan balas dalam Eksperimen 3 dan Nunes dan Weinstein menyumbang kepada kesan batal ujian pada pencerobohan dan penarikan balik palsu yang kritikal.
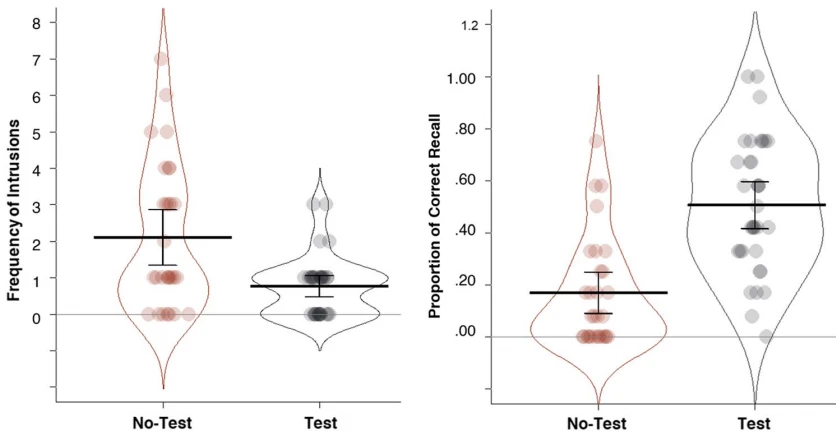
Rajah 8 Kekerapan pencerobohan semasa ingat semula Senarai 5 (kiri) dan bahagian senarai ingat semula betul Senarai 5 (kanan) sebagai fungsi tugas campur tangan dan tahap PI dalam Eksperimen 4. Bar ralat memaparkan deskriptif .95 selang keyakinan. Jitter diperkenalkan untuk menyebarkan titik data secara mendatar untuk meningkatkan keterlihatan titik data
Senaraikan 5 ingatan yang betul
Panel sebelah kanan Rajah 8 menunjukkan nisbah min bagi senarai 5 ingat kembali yang betul. Mencerminkan keputusan daripada Eksperimen 3, peserta dalam keadaan ujian (M=.51) menunjukkan prestasi yang jauh lebih baik berbanding keadaan tanpa ujian (M=.17), t(61)=5.60, p < .001, d=1.42, B10=23280.95. Sesungguhnya, ini adalah kesan yang sangat besar dan ia memberikan bukti yang sangat kukuh yang memihak kepada hipotesis alternatif.
Sekali lagi, terdapat korelasi negatif antara pencerobohan dan ingatan semula yang betul (lihat Rajah 9), r(61)=-.36, p=.004, B10=8.36. Apabila kami membahagikan data mengikut keadaan, korelasi tidak signifikan sama ada dalam keadaan tanpa ujian, r(27)=-.27, p=.160, B01=1.69 , atau keadaan ujian, r(27)=-.02, p=.905, B01=4.66. Tetapi coraknya adalah serupa dengan Eksperimen 1 dan 2, dengan korelasi yang lebih tinggi dipaparkan dalam keadaan kawalan, dan kuasa yang tidak mencukupi berkemungkinan menjadi punca keputusan yang tidak penting ini.
Analisis gabungan
Dalam perkara berikut, kami melaporkan analisis meta yang menggabungkan data merentas empat eksperimen kami dan dua eksperimen dalam Nunes dan Weinstein (2012). Kami menjalankan meta-analisis kesan tetap berdasarkan senarai sasaran prestasi ingatan yang betul. Kami mengekodkan setiap keadaan High-PI dan Low-PI sebagai sampel berasingan dan saiz kesan meta-analitik keseluruhan untuk kesan ujian hadapan merentas sampel ini ialah d=0.89, Z=4.63 , p <.001. Analisis moderator dengan tahap PI sebagai pembolehubah minat menunjukkan bahawa perbezaan dalam PI tidak menjejaskan magnitud kesan ujian hadapan, Z=0.41, p=.680, dengan Tinggi -PI (d=0.95) dan Low-PI (d=.83) sampel yang menghasilkan saiz kesan yang setanding. Saiz kesan yang lebih kecil sedikit untuk kajian Low-PI didorong terutamanya oleh kemasukan data Eksperimen 2 Nunes dan Weinstein (2012). Apabila kajian ini dialih keluar daripada sampel, purata kesan ujian hadapan untuk kajian Low-PI (d=1.01) adalah sama besar dengan kajian High-PI. Pemeriksaan plot hutan dalam Rajah 10 menunjukkan bahawa titik data daripada Eksperimen 2 Nunes dan WeinStein terletak di luar selang keyakinan saiz kesan meta-analisis. Oleh itu, ketiadaan kesan ujian hadapan dalam Eksperimen 2 mereka mungkin disebabkan oleh ralat pensampelan dan/atau kekurangan pengimbangan balas item senarai sasaran.
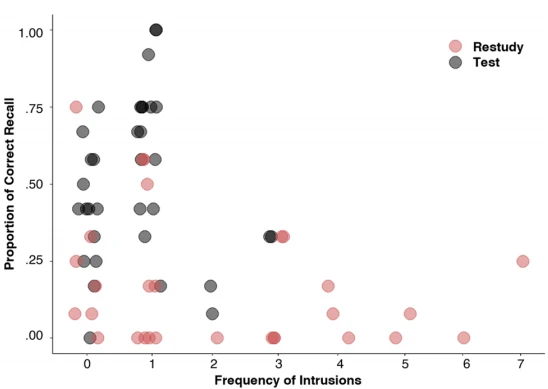
Rajah 9 Plot serakan yang memaparkan hubungan antara kekerapan pencerobohan semasa ingat semula Senarai 5 dan perkadaran ingat semula betul Senarai 5 dalam Eksperimen 4. Untuk meningkatkan keterlihatan ketumpatan data, kami memperkenalkan jitter untuk menyerakkan titik data secara mendatar
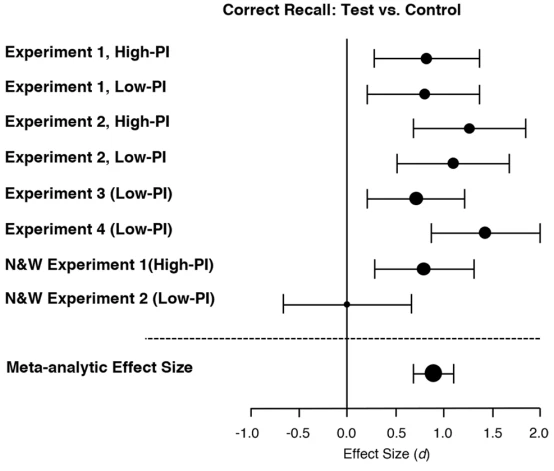
Rajah 10 Plot hutan untuk analisis meta. Setiap titik data menunjukkan saiz kesan ujian hadapan. Saiz penanda data mewakili berat kajian, dan bar ralat memaparkan .95 selang keyakinan
Perbincangan umum
Matlamat kajian ini adalah untuk menyediakan ujian kritikal pelepasan daripada akaun gangguan proaktif kesan ujian hadapan. Dalam Eksperimen 1 dan 2, kami menggunakan kaedah perubahan kandungan untuk memanipulasi PI dan memeriksa sama ada saiz kesan ujian hadapan berbeza mengikut tahap PI. Dalam Eksperimen 3 dan 4, kami mencuba replikasi langsung kajian Nunes dan Weinstein (2012), yang sebahagian besarnya sepadan dengan keadaan PI Rendah kami dalam Eksperimen 1 dan 2. Jika ujian interpolasi menggalakkan pembelajaran baharu dengan mengurangkan PI, kesan ujian hadapan hendaklah dikurangkan atau dihapuskan apabila tahap PI rendah, kerana terdapat sedikit atau tiada PI untuk dikurangkan lagi melalui ujian. Sebaliknya, dalam empat eksperimen, kami mendapati bahawa ujian antara saduran secara konsisten menggalakkan pembelajaran baharu tanpa mengira tahap PI yang dialami oleh peserta.
Keputusan ini menunjukkan bahawa walaupun ujian interpolasi boleh membebaskan peserta daripada kesan negatif gangguan proaktif, faedah ini tidak mungkin menjadi punca kesan ujian hadapan. Invarian kesan ujian ke hadapan terhadap manipulasi PI kami mungkin kelihatan paradoks memandangkan kami secara konsisten memerhatikan korelasi negatif antara ingatan yang betul dan pencerobohan merentas peserta. Pada pandangan pertama, penemuan terakhir ini nampaknya menyokong pelepasan daripada akaun-PI kerana satu tafsiran ialah ujian interpolasi mengurangkan persaingan tindak balas semasa panggil balik, yang memudahkan peserta yang diuji untuk mendapatkan semula item yang dikaji. Data kami mendedahkan dua masalah dengan tafsiran ini. Pertama, korelasi negatif terutamanya didorong oleh peserta yang tidak diuji. Kedua dan lebih penting lagi, hakikat bahawa pengurangan pencerobohan dan peningkatan dalam ingatan yang betul cenderung berlaku bersama tidak membayangkan sebab musabab. Dalam nada yang sama, salah satu korelasi terkuat bagi kesan ujian (ke belakang) ialah prestasi amalan perolehan semula. Dalam meta-analisis literatur, Rowland (2014) menunjukkan bahawa kajian yang melaporkan prestasi amalan perolehan semula yang lebih baik cenderung untuk menghasilkan kesan ujian yang lebih besar. Melukis hujah kausal berdasarkan persatuan ini mungkin menyebabkan seseorang meramalkan bahawa amalan pengambilan semula hanya akan memberi manfaat kepada pembelajaran apabila ia berjaya, tetapi kajian kini menunjukkan bahawa amalan pengambilan semula yang tidak berjaya boleh meningkatkan pengekalan (Carneiro et al., 2018; Davis et al., 2017; Knight et al., 2012; Pyc & Rawson, 2010, 2012).

Supplement cistanche dekat saya
Begitu juga, faedah ujian hadapan nampaknya dikaitkan dengan, tetapi tidak bergantung pada, kesan keluaran-dari-PI. Kami percaya bahawa korelasi negatif antara pencerobohan dan ingatan yang betul didorong oleh pembolehubah ketiga, dan satu calon yang mungkin ialah ujian menggalakkan organisasi semantik dalam ingatan (Chan, Manley, et al., 2018; Zaromb & Roediger, 2010). Penyelidikan terkini telah menunjukkan bahawa, merentas ujian berturut-turut, pelajar menjadi semakin berkemungkinan untuk mengelompokkan item berkaitan semantik semasa mengingat semula, dan tahap pengelompokan dikaitkan secara positif dengan prestasi ingatan yang betul (Chan et al., 2020; Yang et al., 2021). Kami baru-baru ini mengaitkan organisasi memori yang dipertingkatkan ini kepada peserta yang mengoptimumkan pengekodan dan strategi perolehan semula mereka merentas senarai (Chan et al., 2020; Chan, Manley, et al., 2018). Walaupun kajian dalam literatur ujian hadapan hanya menyiasat pengelompokan berdasarkan hubungan semantik, kajian lain menunjukkan bahawa ujian juga boleh meningkatkan pengelompokan dan pengasingan temporal. Khususnya, ujian interpolasi boleh menggalakkan keupayaan pelajar untuk mengelompokkan item yang telah dikaji dalam jarak masa yang dekat (iaitu, item yang dikaji dalam senarai yang sama), manakala pada masa yang sama mengasingkan item yang dikaji sebelum atau selepas pengambilan semula (iaitu, item yang dikaji merentas senarai; Brewer et al., 2010; Chan & McDermott, 2007; Jang & Huber, 2008; Kliegl & Bäuml, 2021; Wahlheim, 2015; Yang et al., 2021). Seperti yang dispekulasi oleh Darley dan Murdock (1971), menukar antara pengekodan dan tugas mendapatkan semula mungkin memberi peluang kepada pelajar untuk melabel atau menandai item secara mental berdasarkan sama ada ia telah diuji sebelum ini atau tidak (Davis et al., 2017), dan mekanisme pelabelan ini. boleh mengurangkan pencerobohan (Pierce et al., 2017) sama ada melalui pemilihan awal atau mekanisme pembetulan lewat. Dari perspektif pemilihan awal, peserta mungkin mengekang pengambilan mereka di bahagian hadapan dengan mencuba carian ingatan mereka melalui item yang mereka tidak dapat diperolehi sebelum ini (Rugg et al., 2000; Shimizu & Jacoby, 2005); sebagai alternatif, peserta mungkin mencuba carian memori yang luas dan kemudian menahan output item yang dipanggil semula sebelum ini. Mekanisme pemilihan awal – iaitu, pengambilan semula terhad – mungkin berfungsi untuk meningkatkan ingatan yang betul (dengan mengurangkan set carian) dan mengurangkan pencerobohan (kerana item yang diuji sebelum ini tiada dalam set carian), dengan itu menghasilkan korelasi negatif antara pembolehubah bersandar ini .
Baru-baru ini, penyelidik telah mendakwa bahawa kesan pengurangan PI bagi pengambilan menyumbang kepada kesan ujian hadapan (Dang et al., 2021; Yang et al., 2021). Sokongan untuk hujah ini adalah berdasarkan analisis pengantaraan di mana pencerobohan senarai terdahulu berfungsi sebagai pengantara yang signifikan antara pembolehubah bebas aktiviti interpolasi (iaitu, ujian lwn kajian semula) dan pembolehubah bersandar ingatan yang betul, dan penyelidik mentafsir secara tidak langsung ini kesan sebagai pengambilan semula penebat pelajar daripada PI, yang seterusnya menggalakkan pembelajaran baharu. Walau bagaimanapun, kami berhati-hati terhadap tafsiran sedemikian dalam kes semasa kerana tiada keutamaan temporal antara pengantara (iaitu, pencerobohan) dan pembolehubah bersandar (iaitu, ingatan yang betul). Sebaliknya, pencerobohan dan ingatan yang betul berlaku semasa fasa eksperimen yang sama, menjadikannya mustahil untuk membuat kesimpulan sebab melalui susunan temporal (iaitu, sesuatu yang berlaku kemudian tidak boleh menyebabkan sesuatu yang berlaku lebih awal; Aalen et al., 2012; Hayes, 2018; Preacher, 2015 ; Walters, 2019). Sesungguhnya, adalah mungkin untuk membalikkan peranan pengantara dan pembolehubah bersandar dalam analisis yang dilakukan oleh Dang et al. (2021) dan Yang et al. (2021), supaya ingatan yang betul berfungsi sebagai pengantara dan pencerobohan berfungsi sebagai pembolehubah bersandar. Untuk meneroka kemungkinan ini, kami menjalankan analisis pengantaraan menggunakan data yang Dang et al. dan Yang et al. disediakan pada Rangka Kerja Sains Terbuka.
Kami mula-mula cuba untuk meniru analisis pengantaraan asal mereka, dan keputusan model kami adalah konsisten dengan mereka, sehingga terdapat kesan tidak langsung yang ketara daripada pencerobohan pada ingatan semula yang betul.2 Kami kemudiannya memeriksa daya maju model pengantaraan terbalik. Seperti yang telah kami duga, kesan tidak langsung model terbalik ini juga ketara, -0.238 [-0.418, -0.112] dalam Dang et al., dan {{7 }}.942 [-1.217, -0.666] dalam Yang et al., menunjukkan bahawa ujian interpolasi mempengaruhi pencerobohan senarai terdahulu melalui penarikan balik yang betul. Kepentingan model terbalik ini menyerlahkan kesukaran apabila mentafsir keputusan analisis pengantaraan di mana pengantara dan pembolehubah bersandar tidak mempunyai keutamaan temporal yang jelas.
Kami akan lalai untuk tidak menyebut bahawa dalam laporan baru-baru ini, Chan, Manley, et al. (2018) mencadangkan bahawa ujian interpolasi mungkin meningkatkan pembelajaran baharu dalam paradigma pembelajaran senarai yang dikategorikan dengan meningkatkan kemungkinan peserta akan melihat sifat senarai yang dikategorikan. Ideanya ialah apabila peserta menyedari sifat senarai yang dikategorikan, mereka akan cuba mengekod hubungan semantik merentas item senarai yang serupa, yang seharusnya meningkatkan pembelajaran. Chan et al. seterusnya memberi alasan bahawa, jika hipotesis ini betul, menjadikan sifat senarai yang dikategorikan mudah ditemui (contohnya, dengan mengemukakan perkataan dari kategori yang sama dalam blok) harus mengurangkan kelebihan ujian ke hadapan, dan mereka memetik Nunes dan Weinstein (2012) sebagai menyediakan sokongan awal untuk hipotesis sedemikian. Keputusan sekarang jelas bertentangan dengan ramalan ini.
Had
Satu batasan kajian ini ialah hanya bentuk pengambilan semula PI telah ditangani kerana kami mengukur pencerobohan. Tetapi pengekodan juga boleh dipengaruhi oleh pembentukan PI kerana sumber perhatian pelajar boleh merosot apabila mereka terus mengekod maklumat. Sebagai contoh, dalam kajian EEG, Pastötter dan rakan sekerja (2011) melaporkan bahawa ujian interpolasi meningkatkan pengekodan maklumat baharu dengan mengurangkan ketidakpedulian, seperti yang dibuktikan oleh peningkatan kuasa alfa (kaitan elektrofisiologi ketidakpedulian) merentas senarai untuk peserta kawalan, tetapi tidak untuk peserta yang diuji. Tambahan pula, Szpunar dan rakan sekerja (Szpunar et al., 2013; Jing et al., 2016; lihat juga Pan et al., 2020, untuk pembiayaan yang sama dengan praujian dan bukannya ujian interpolasi) menunjukkan bahawa, apabila melihat kuliah rakaman video , peserta yang menerima ujian interpolasi setiap 5 minit adalah kurang berkemungkinan melaporkan kembara fikiran berbanding peserta kawalan. Walau bagaimanapun, seperti yang dinyatakan sebelum ini, kami percaya bahawa mekanisme berasaskan perhatian sedemikian harus dianggap sebagai berbeza daripada akaun keluaran-dari-PI kerana membenarkan akaun ini memasukkan mekanisme berasaskan perhatian/pengekodan akan menjadikan akaun tersebut terlalu luas dan sukar untuk dipalsukan.
Kajian kami, seperti kebanyakan kajian tingkah laku, juga tidak membenarkan kami membezakan pengekodan dan kesan berasaskan perolehan semula, kerana manipulasi pengekodan kami (iaitu, High-PI lwn. LowPI) boleh, dan berkemungkinan besar, mempunyai kesan melata pada perolehan semula. Kajian masa depan mungkin cuba untuk memisahkan pengekodan dan kesan pengambilan semula kesan ujian ke hadapan menggunakan pengimejan otak atau kaedah elektrofisiologi yang menyediakan data masa nyata semasa pengekodan (Pastötter et al., 2011; lihat juga Beardsley et al., 2018).
Isu lain yang ingin kami tangani ialah definisi operasi PI. Dalam eksperimen ini, kami telah menggunakan kekerapan pencerobohan sebagai ukuran PI, seperti kebanyakan kajian dalam literatur kesan ujian hadapan. Tetapi dalam era pembelajaran lisan, prestasi ingatan yang betul kerap digunakan untuk menunjukkan kesan PI. Sebagai contoh, apabila membandingkan prestasi ingatan antara peserta yang mengkaji senarai AD tunggal (tanpa kajian terdahulu) dengan peserta yang mengkaji senarai AB sebelum senarai AD, pengurangan dalam ingatan AD disebabkan pembelajaran terdahulu dianggap sebagai bukti untuk PI. Mengguna pakai definisi ini, seseorang mungkin berpendapat bahawa manipulasi PI kami tidak mempunyai kesan kerana peserta kawalan secara konsisten menunjukkan prestasi ingatan betul yang lebih lemah pada senarai sasaran berbanding dengan prestasi ingat semula Senarai 1 peserta yang diuji (yang setara dengan sekumpulan peserta yang tidak mempunyai kajian terdahulu, lihat Jadual 1). Walau bagaimanapun, menerima pakai takrifan PI ini untuk kesan ujian hadapan akan menjadikan akaun keluaran daripada PI semata-mata deskriptif (bukan penjelasan), kerana apabila kesan ujian hadapan ditemui, mengikut definisi, peserta dalam keadaan yang diuji mesti mengatasi prestasi dalam keadaan kawalan. Menuntut perbezaan seperti pelepasan-dari-PI hanya menyatakan semula, bukannya menerangkan, fenomena itu.
Akhir sekali, kami mengakui bahawa saiz sampel kami terlalu kecil untuk mengesan interaksi antara aktiviti interim dan tahap PI. Jika saiz kesan sederhana (cth, f=.2) diandaikan untuk kesan interaksi dengan tahap alfa kuasa .05 dan .80, jumlah saiz sampel sebanyak 199 peserta akan diperlukan. Seseorang mungkin menyedari bahawa saiz kesan ujian hadapan adalah lebih kecil dalam keadaan PI Rendah berbanding dalam keadaan PI Tinggi daripada kedua-dua Eksperimen 1 (PI Rendah =.14, PI Tinggi=.20 ) dan Percubaan 2 (PI Rendah=.23, PI Tinggi=.31), dan satu tafsiran perbezaan tidak ketara ini ialah kesan ujian hadapan kurang ketara apabila peserta mengalami kurang PI. Walau bagaimanapun, kami berhati-hati terhadap perbezaan tafsiran yang berlebihan berdasarkan kebarangkalian mentah kerana ia tidak mengambil kira perbezaan dalam kebolehubahan data. Apabila kita meneliti data yang sama dengan Cohen's d, ia menjadi jelas bahawa perbezaan peratusan lebih jelas daripada sebenar. Khususnya, kesan ujian hadapan ialah .81 dalam keadaan PI Rendah dan .82 dalam keadaan PI Tinggi dalam Eksperimen 1, 1.09 dalam keadaan PI Rendah dan 1.20 dalam keadaan PI Tinggi dalam Eksperimen 2. Namun begitu, masih berkemungkinan bahawa interaksi antara keadaan PI dan aktiviti interim adalah tidak signifikan kerana kuasa statistik yang rendah. Dalam erti kata lain, keluaran-dari-PI mungkin telah memberikan sedikit sumbangan kepada kesan ujian hadapan, tetapi percubaan kami tidak dikuasakan secukupnya untuk mengesannya. Oleh itu, penyelidikan masa depan yang menyiasat hubungan antara tahap PI dan aktiviti interim akan mendapat manfaat daripada sampel yang lebih besar.
Mengakhiri ucapan
Dalam percubaan ini, kami menyediakan ujian kritikal akaun keluaran-dari-PI, yang secara meluas dianggap sebagai salah satu penjelasan calon utama untuk kesan ujian hadapan. Sepanjang empat percubaan, kami secara konsisten memerhati data yang melanggar ramalannya. Yang penting, kami gagal meniru pembiayaan Nunes dan Weinstein (2012), yang sebelum ini menyediakan bukti penting untuk akaun keluaran-daripadaPI. Sekurang-kurangnya, data kami mencadangkan bahawa sekiranya pelepasan-dari-PI menyumbang kepada kesan ujian hadapan, ia berkemungkinan memainkan peranan yang lebih kecil daripada yang dijangkakan sebelum ini.
Oleh kerana kajian kami direka bentuk untuk menguji hipotesis keluaran-dari-PI, ia tidak dapat menangani persoalan "jika pelepasan daripada gangguan proaktif bukan faktor penyebab untuk kesan ujian ke hadapan, apakah itu?" Nasib baik, beberapa penjelasan yang berpotensi berdaya maju kekal. Sebagai contoh, ujian interpolasi mungkin mempotensikan pembelajaran baharu dengan menggalakkan pengekodan penuh perhatian (Chan et al., 2020; Szpunar, 2017; Szpunar et al., 2013; Weinstein et al., 2014). Kemungkinan lain ialah ujian mungkin membolehkan pelajar membangunkan strategi pengekodan/pendapatan yang lebih berkesan yang memanfaatkan organisasi ingatan yang lebih baik (Chan et al., 2020; Dang et al., 2021) atau pengasingan kontekstual (Yang et al., 2021). Penyelidikan masa depan yang menangani akaun ini secara langsung akan membantu menggalakkan pemahaman kami tentang kesan ujian hadapan.
Rujukan
Aalen, OO, Røysland, K., Gran, JM, & Ledergerber, B. (2012). Kausalitas, pengantaraan dan masa: Sudut pandangan dinamik. Jurnal Persatuan Statistik Diraja. Siri A: Statistik dalam Masyarakat, 175(4), 831–861. https://doi.org/10.1111/j.1467-985X.2011. 01030.x
Bäuml, KHT, & Kliegl, O. (2013). Peranan kritikal proses mendapatkan semula dalam pelepasan daripada gangguan proaktif. Jurnal Ingatan dan Bahasa, 68(1), 39–53. https://doi.org/10.1016/j. jml.2012.07.006
Beardsley, M., Hernández-Leo, D., & Ramirez-Melendez, R. (2018). Mencari kebolehulangan: Menilai kajian multimodal kesan ujian. Journal of Computer Assisted Learning, 34(4), 378-386. https://doi.org/10.1111/jcal.12265
Bonner, SM (2009). Menyiasat penggunaan ujian amalan guru untuk tujuan formatif. Jurnal Penilaian Pelbagai Disiplin, 6(12), 125-136.
Brewer, GA, Marsh, RL, Meeks, JT, Clark-Foos, A., & Hicks, JL (2010). Kesan ujian ingat semula percuma pada ingatan sumber seterusnya. Ingatan, 18(4), 385–393. https://doi.org/10. 1080/09658211003702163
Brown, J. (1958). Beberapa ujian teori pereputan ingatan segera. Jurnal Suku Tahunan Psikologi Eksperimen, 10(1), 12–21.https://doi.org/10.1080/17470215808416249
Carneiro, P., Lapa, A., & Finn, B. (2018). Kesan pencarian semula yang tidak berjaya terhadap pembelajaran seterusnya kanak-kanak. Jurnal Psikologi Kanak-kanak Eksperimen, 166, 400–420. https://doi.org/10. 1016/j.jecp.2017.09.010
Chan, JCK, & McDermott, KB (2007). Kesan ujian dalam ingatan pengecaman: Akaun dwi proses. Jurnal Psikologi Eksperimen: Memori Pembelajaran dan Kognisi, 33(2), 431–437.https://doi.org/10.1037/0278-7393.33.2.431
Chan, JCK, Manley, KD, & Lang, K. (2017). Kebolehcadangan yang dipertingkatkan semula: Penyiasatan retrospektif dan baharu. Jurnal Penyelidikan Gunaan dalam Ingatan dan Kognisi, 6(3), 213–229. https://doi.org/10.1016/j.jarmac.2017.07.003
Chan, JCK, Manley, KD, Davis, SD, & Szpunar, KK (2018). Pengujian mempotensikan pembelajaran baharu merentas selang pengekalan dan ketinggalan: Perspektif perubahan strategi. Jurnal Ingatan dan Bahasa, 102(Mei), 83–96. https://doi.org/10.1016/j.jml. 2018.05.007
Chan, JCK, Meissner, CA, & Davis, SD (2018). Pengambilan semula mempotensikan pembelajaran baharu: Kajian teori dan meta-analisis. Buletin Psikologi, 144(11), 1111–1146. https:// doi.org/10.1037/bul0000166
Chan, JCK, Manley, KD, & Ahn, D. (2020). Adakah pengambilan semula mempotensikan pembelajaran baharu apabila pengambilan berhenti tetapi pembelajaran baharu diteruskan? Jurnal Ingatan dan Bahasa, 115(Julai), 104150. https://doi.org/10.1016/j.jml.2020.104150
Conway, ARA, Kane, MJ, Bunting, MF, Hambrick, DZ, Wilheim, O., & Engle, RW (2005). Tugas rentang memori kerja: Kajian metodologi dan panduan pengguna. Buletin dan Kajian Psikonomik, 12(5), 769–786. https://doi.org/10.1021/ can-v020n021.p1399
Dang, X., Yang, C., & Chen, Y. (2021). Perbezaan umur dalam kesan ujian ke hadapan: Peranan perubahan strategi dan pelepasan daripada gangguan proaktif. Perkembangan Kognitif, 59(Jun), 101079.https://doi.org/10.1016/j.cogdev.2021.101079