Cabaran Dan Peluang Dengan Algoritma Penemuan Sebab: Aplikasi Kepada Patofisiologi Alzheimer
Feb 19, 2022
Xinpeng Shen1*, Sisi Ma1et al
Causal Structure Discovery (cSD) ialah masalah mengenal pasti hubungan sebab akibat daripada kuantiti data yang besar melalui kaedah pengiraan. Dengan keupayaan terhad kaedah pengiraan berasaskan persatuan tradisional untuk menemui hubungan sebab akibat, metodologi cSD semakin popular. matlamat kajian adalah untuk mengkaji secara sistematik sama ada (i) kaedah cSD boleh menemui hubungan sebab-akibat yang diketahui daripada data klinikal pemerhatian dan (ii) untuk menawarkan panduan untuk menemui hubungan sebab-akibat yang diketahui dengan tepat. Kami menggunakanPenyakit Alzheimer(AD), penyakit progresif yang kompleks, sebagai model kerana bukti yang mantap menyediakan graf penyebab "standard emas" untuk penilaian. Kami menilai dua kaedah cSD, inferens sebab cepat (FCI) dan Carian kesetaraan Greedy pantas (fGeS) dalam keupayaan mereka untuk menemui struktur ini daripada data yang dikumpul olehPenyakit Alzheimerinisiatif neuroimaging (ADni). Kami menggunakan model persamaan struktur (yang tidak direka untuk cSD) sebagai kawalan. Kami menggunakan kaedah ini di bawah tiga senario yang ditakrifkan dengan meningkatkan jumlah pengetahuan latar belakang yang diberikan kepada kaedah tersebut. kaedah dinilai dengan membandingkan hubungan sebab akibat dengan graf "standard emas" yang dibina daripada kesusasteraan. Kaedah cSD yang berdedikasi berjaya menemui graf yang hampir bertepatan dengan standard emas. untuk hasil yang terbaik, algoritma cSD harus digunakan dengan data membujur yang memberikan sebanyak mungkin pengetahuan terdahulu.
Hubungi:joanna.jia@wecistanche.com/ WhatsApp: 008618081934791

Kesan daripadaekstrak cistanchefenoksietanol glikosida padaAlzheimer
Analisis data besar, pembelajaran mesin dan pembelajaran mendalam telah menarik minat yang ketara dalam bidang sains kesihatan1,2. Oleh kerana ketepatan ramalan yang sangat baik, mereka semakin banyak digunakan untuk diagnosis penyakit dan ramalan risiko3. Walau bagaimanapun, dalam banyak aplikasi bioperubatan, mencapai ketepatan ramalan yang tinggi dalam dan dengan sendirinya bukanlah matlamat utama; menemui faktor risiko atau mekanisme yang boleh diubah sering menjadi persoalan kajian utama.
Aplikasi pembelajaran mesin hari ini sebahagian besarnya berdasarkan persatuan. Walaupun faktor risiko mungkin dikaitkan dengan penyakit ini, ia tidak semestinya bermakna ia boleh mengubah proses penyakit. Pada awal 2018, percubaan Fasa 3 yang dipanggil "ESOK" menguji kesan ubat diabetes terhadap mengurangkanPenyakit Alzheimer(AD) risiko demensia4. Kajian itu mengukur pemendapan amiloid, yang merupakan tanda awal penyakit Alzheimer dan juga dikaitkan dengan diabetes. Walau bagaimanapun, oleh kerana diabetes bukan penyebab kepada amyloidosis, kajian itu gagal dalam analisis interim5,6. Untuk campur tangan yang berjaya, faktor risiko yang kita campur tangan harus mempunyai hubungan kausal (bukan hanya bersekutu) denganpenyakithasil.
Penyelidikan klinikal kebanyakannya tertumpu pada hubungan kausal. Penyelidikan klinikal yang didorong oleh hipotesis, sebagai contoh, sering menganggap struktur sebab, satu set hubungan sebab akibat antara biomarker dan hasil, dan penyelidik menganggarkan saiz kesan hubungan ini (cth. inferens sebab). Dalam penyelidikan sedemikian, membuat kesimpulan kausal adalah sah, kerana pengetahuan terdahulu memastikan bahawa perhubungan itu memang bersebab. Walau bagaimanapun, apabila tiada pengetahuan tentang sebab-akibat, struktur sebab-akibat itu sendiri perlu ditemui daripada data melalui proses yang dikenali sebagai penemuan struktur sebab-akibat. Amalan yang biasa digunakan tetapi tidak betul ialah menganggap struktur sebab-akibat separa dan melaraskannya berdasarkan statistik keluaran model yang dipasang menggunakan kaedah seperti model persamaan struktur (SEM).
Dalam kerja ini, menggunakan biomarker AD sebagai peramal dan kognisi sebagai hasilnya, kami menetapkan untuk menentukan cara yang optimum untuk menemui hubungan sebab akibat. Kami menggunakan AD sebagai model untuk masalah ini kerana lata biomarker AD difahami dengan baik7 dan hubungan sebab akibat antara peramal utama juga telah dicirikan dengan baik supaya graf "standard emas" boleh dibina. Selanjutnya, set data awam bagiPenyakit Alzheimer← neuroimaging initiative (ADNI) mempunyai data longitudinal yang luas tersedia yang kondusif untuk perbandingan sistematik yang dirancang dalam manuskrip ini. Di sini, kami menumpukan pada membandingkan hasil daripada algoritma penemuan sebab akibat khusus dan algoritma carian berdasarkan SEM, dengan graf "standard emas" kami. Kami juga menyiasat sebab di sebalik kesilapan biasa dan meneroka kaedah untuk mencegahnya. Eksperimen ini membenarkan kami menyediakan garis panduan untuk menemui struktur sebab menggunakan data pemerhatian.

Cistanche MencegahAlzheimer
Latar belakang
algoritma penemuan struktur sebab.Secara tidak formal, sebab musabab ditakrifkan sebagai hubungan antara dua pembolehubah X dan Y supaya perubahan dalam X membawa kepada perubahan dalam Y8. Perbezaan utama antara persatuan dan penyebaban terletak pada potensi mengelirukan. Katakan tiada hubungan sebab akibat langsung wujud antara X dan Y sebaliknya pembolehubah ketiga Z menyebabkan kedua-dua X dan Y. Dalam kes ini, walaupun X dan Y berkait kuat, mengubah X tidak akan membawa kepada perubahan dalam Y. Z dipanggil a mengelirukan. Secara lebih formal, sebab musabab ialah kesan langsung antara A dan B yang kekal selepas dilaraskan untuk mengelirukan. Pengelirukan boleh diperhatikan atau tidak diperhatikan (terpendam).
Struktur kausal ialah set perhubungan kausal di antara satu set pembolehubah, dan penemuan struktur kausal ialah masalah mempelajari struktur kausal daripada data pemerhatian. Algoritma penemuan struktur kausal khusus wujud dan boleh dipisahkan kepada dua subjenis, berasaskan kekangan dan berasaskan skor. Algoritma berasaskan kekangan membina struktur sebab berdasarkan kekangan kebebasan bersyarat, manakala algoritma berasaskan skor menjana beberapa graf penyebab calon, memberikan skor kepada setiap satu, dan pilih graf akhir berdasarkan skor. Dalam kajian ini, kami memilih satu algoritma yang menonjol daripada setiap jenis: Algoritma Inferens Sebab Cepat (FCI), yang merupakan algoritma berasaskan kekangan dan Carian Kesetaraan Tamak Cepat (FGES), yang merupakan algoritma berasaskan skor. Untuk ringkasnya, kami memberikan penerangan peringkat tinggi untuk FGES dan FCI. Untuk penerangan yang lebih terperinci, kami merujuk pembaca kepada rujukan9–11. Kedua-dua kaedah boleh melaraskan pengaliran yang diperhatikan dan salah satu daripada algoritma, FCI, mempunyai sedikit keupayaan untuk menemui pengaliran terpendam.
inferens sebab cepat (fci).Konsep utama di sebalik algoritma penemuan kausal berasaskan kekangan ialah idea bahawa struktur kausal yang berbeza membayangkan hubungan kebebasan yang berbeza. Sebagai contoh, hubungan sebab akibat A→- B →C, membayangkan bahawa pembolehubah A adalah bebas daripada C diberi B. Sebaliknya, apabila A →C←B, A, dan B adalah bebas (tanpa syarat), tetapi menjadi bersandar bersyarat pada C. Struktur yang terakhir ini dipanggil struktur "V" (juga dikenali sebagai collider) yang mempunyai hubungan bebas yang unik berbanding dengan hubungan sebab-akibat yang lain. Malah, ia adalah salah satu "primitif" yang dicari oleh algoritma berasaskan kekangan, seperti FCI.
Ciri khusus untuk FCI walaupun dalam kalangan kaedah berasaskan kekangan ialah keupayaannya untuk menemui pengacau terpendam (tidak diperhatikan). Ini didayakan oleh satu lagi primitif, struktur "Y". Empat pembolehubah mentakrifkan struktur "Y" apabila ia mempunyai hubungan sebab-akibat berikut: W1 →X ← W2 dan X →Y. Dalam struktur "Y", kedua-dua W1 dan W2 adalah bebas daripada Y bersyarat pada X. Kebebasan bersyarat ini membantu menolak kemungkinan pengacau yang tidak terukur antara X dan Y. Dengan kata lain, apabila FCI menemui struktur "Y" dalam graf, hubungan sebab akibat dari X ke Y dijamin tidak dikelirukan; jika tidak, FCI menganggap bahawa kemungkinan pengacau yang tidak diperhatikan wujud12.
Algoritma inferens sebab cepat (FCI). FCI membina graf kausal bermula dengan graf tidak terarah yang disambungkan sepenuhnya dan membuang tepi yang menghubungkan pembolehubah bebas bersyarat. Dalam fasa kedua, ia mengorientasikan tepi dengan mengenal pasti struktur "V" dan "Y" dan cuba mengorientasikan tepi yang tinggal berdasarkan set peraturan yang telah dijelaskan secara terperinci di tempat lain9,13.
Algoritma carian kesetaraan tamak (FGES) pantas.Algoritma Greedy Equivalence Search (GES) juga mempunyai dua fasa. Fasa pertama bermula dengan graf yang tidak mengandungi tepi (sepadan dengan semua pembolehubah yang bebas antara satu sama lain) dan dengan rakus menambah tepi (bergantungan) satu demi satu dalam orientasi yang meminimumkan Bayes Information Score14 (BIC), yang berkemungkinan dikenakan penalti untuk kerumitan untuk mengurangkan overfitting. GES kemudian mengeluarkan tepi satu demi satu selagi ia mengurangkan BIC. Algoritma FGES10 yang digunakan dalam kerja ini hanyalah versi "pantas" (disejajarkan) GES11,15. Sama seperti FCI, FGES juga bergantung pada struktur "V" untuk mengorientasikan tepi. Kemungkinan tersirat bagi struktur "V" adalah unik manakala kemungkinan A →B →C, C →B →A, dan A ←BC adalah sama. Jadi, FGES akan memilih struktur "V" apabila ia membayangkan kemungkinan yang lebih tinggi daripada struktur lain.
Pemodelan persamaan struktur (SEM).Structural Equation Modelling (SEM) ialah keluarga model statistik, yang, memandangkan struktur penyebab yang mendasari, boleh menganggarkan saiz kesan (dan juga statistik lain) bagi setiap perhubungan16. SEM juga boleh mencadangkan pengubahsuaian kepada struktur kausal yang diberikan untuk menambah baik statistik kesesuaian model.
Walaupun SEM tidak direka bentuk untuk menemui struktur sebab, ia adalah perkara biasa untuk menggunakan pengubahsuaian yang disyorkan SEM untuk "memperhalusi" struktur graf. Ciri ini boleh dieksploitasi untuk membina graf kausal secara berulang, dalam setiap lelaran, menambah satu kelebihan mengikut cadangan SEM. Kami melaksanakan kaedah carian (salah) ini di bawah dua senario: (1) bermula daripada graf kosong (Penemuan sebab); dan (2) bermula daripada graf yang diperoleh dengan memotong 1 atau 2 tepi daripada graf "standard emas". Ambil perhatian bahawa, dalam skop kertas ini, kami menggunakan istilah "SEM" untuk mewakili algoritma yang menggunakan SEM untuk menjalankan carian tepi, bukan untuk menganggarkan saiz kesan.
Perbezaan utama antara algoritma. Kedua-dua SEM dan FGES ialah algoritma langkah demi langkah yang mengubah suai struktur dengan menambah atau memadamkan tepi. Kelebihan terbesar FGES ialah ia memanjangkan ruang carian dengan mengubah struktur semasa kepada struktur "setara" yang lain. Sebagai contoh, diberi tepi, A →B berada dalam graf A, B dan C. SEM akan cuba menambah satu tepi terarah antara C dan A atau C dan B, menghasilkan empat kemungkinan. Walau bagaimanapun, FGES mempertimbangkan lebih banyak kemungkinan kerana ia juga boleh membalikkan tepi sedia ada A →B kepada A ←B, menghasilkan empat kemungkinan struktur tambahan.
Selain daripada strategi carian (Berasaskan Kekangan berbanding Skor), FCI juga berbeza daripada dua algoritma lain dalam andaian tentang sebab: kedua-dua SEM dan FGES beroperasi di bawah andaian tiada pengacau yang tidak diukur. Dalam erti kata lain, semua pembolehubah yang mengelirukan diukur dalam set data. FCI, walau bagaimanapun, melonggarkan andaian ini dan melaporkan hubungan yang tidak mengelirukan hanya apabila ia menemui struktur "Y"17.
Algoritma FCI dan FGES dilaksanakan dalam pakej perisian Tetrad (Versi 6.5.4). Rajah 1 menunjukkan tafsiran jenis tepi yang berbeza dalam graf keluaran. Untuk SEM, kami menggunakan pakej R 'lavaan'18.
Kaedah
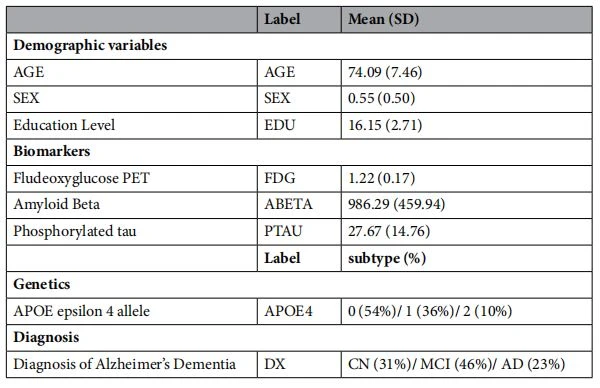
Data.Data yang digunakan dalam penyediaan artikel ini diperoleh daripadaPenyakit AlzheimerPangkalan data Neuroimaging Initiative (ADNI) (adni.loni.usc.edu). ADNI telah dilancarkan pada tahun 2003 sebagai perkongsian awam-swasta, diketuai oleh Penyiasat Utama Michael W. Weiner, MD. Matlamat utama ADNI adalah untuk menguji sama ada pengimejan resonans magnetik bersiri (MRI), tomografi pelepasan positron (PET), penanda biologi lain, dan penilaian klinikal dan neuropsikologi boleh digabungkan untuk mengukur perkembangan kecacatan kognitif ringan (MCI) dan awal.Alzheimerpenyakit(AD)19. Terdapat tiga fasa kajian ADNI di mana yang terakhir, ADNI3, masih berterusan. Semua peserta kajian memberikan persetujuan termaklum bertulis, dan protokol kajian telah diluluskan oleh setiap lembaga semakan institusi tapak tempatan. Semua kaedah telah dijalankan mengikut garis panduan dan peraturan yang berkaitan. Untuk maklumat terkini, lihat www.adni-info.org. Semakan LHDN tidak diperlukan kerana data ADNI dinyahkenal pasti dan tersedia secara umum untuk dimuat turun. Kami menumpukan kajian kami pada dua yang pertama: ADNI 1 dan ADNI 2/GO. Pembolehubah yang diekstrak daripada data ialah fludeoxyglucose PET (FDG), amyloid-beta (ABETA), tau fosforilasi (PTAU), apolipoprotein E (APOE) ε4 alel; maklumat demografi: umur, jantina, pendidikan (EDU); dan diagnosis pada AD (DX). Jadual 1 membentangkan statistik ringkasan set data. Selepas mengalih keluar rekod dengan nilai yang hilang, terdapat 1008 peserta yang tinggal dengan sekurang-kurangnya satu rekod lengkap, dan 266 dengan lawatan susulan tetap selama dua tahun.

graf "standard emas".Lata biomarker AD telah dinilai secara meluas. Pemendapan ABETA di dalam otak adalah peristiwa awal dalam proses penyakit dan ditangkap melalui penurunan CSF ABETA. Faktor risiko ABETA yang ditunjukkan ialah umur dan bilangan alel APOE46,20,21. ABETA menyebabkan pembentukan kusut neurofibrillary hiliran dan seterusnya neurodegenerasi, yang kedua-duanya ditangkap oleh disfungsi metabolik melalui peningkatan FDG-PET22 dan PTAU yang diukur pada CSF23. Dua penanda FDG-PET dan CSF PTAU adalah peramal terkuat bagi disfungsi kognitif atau diagnosis24,25 (berbanding ABETA). Pendidikan, pengganti kepada daya tahan kognitif, mempengaruhi status kognitif individu26. Semua ini adalah hubungan yang mantap dalam kesusasteraan. Terdapat perkaitan sebab yang lebih lemah seperti jantina yang mempengaruhi beberapa perkaitan ini yang kami tidak ambil kira untuk menilai algoritma kerana impak perkaitan ini adalah jauh lebih kecil berbanding dengan kesan utama yang dipertimbangkan dalam graf "standard emas". Hubungan yang diterangkan di atas ditunjukkan dalam Rajah 2.
Pengetahuan latar belakang dan data keratan rentas vs membujur.Untuk mengekang hubungan yang boleh ditemui oleh algoritma, pengetahuan latar belakang boleh disediakan dalam bentuk tepi mesti ada atau mesti tidak ada (terlarang). Dalam makalah ini, kami mentakrifkan tiga darjah pengetahuan latar belakang sebagai: (Tahap 1) Tiada pengetahuan: struktur yang ditemui mencerminkan data semata-mata; tiada tepi dilarang. (Tahap 2) Pengetahuan latar belakang remeh: (a) tepi antara pembolehubah demografi adalah dilarang (walaupun perkaitan antara mereka boleh kekal) (b) tepi daripada biomarker atau diagnosis kepada pembolehubah demografi adalah dilarang. (Tahap 3)

Reka bentuk kajian.Kajian penemuan sebab. Kami mengekstrak dua set data daripada ANDI untuk bahagian kajian ini: satu adalah keratan rentas tunggal dan data dikumpulkan pada lawatan garis dasar yang dibuat oleh setiap peserta. Yang kedua ialah membujur, di mana kami memasukkan data daripada dua keratan rentas: lawatan garis dasar dan lawatan yang dibuat pada 24 bulan. Rekod dengan data yang hilang telah dialih keluar daripada kajian lanjut.
Untuk menjana hasil yang mantap, kedua-dua data keratan rentas dan membujur telah diikat 100 kali pada tahap peserta. Sepuluh, tiga algoritma, SEM, FCI dan FGES telah diuji pada semua sampel bootstrap untuk penilaian, menggabungkan tiga darjah pengetahuan berbeza yang diterangkan dalam bahagian sebelumnya.
Kajian pemulihan SEM. Memandangkan kebanyakan penyelidik akan bermula dengan graf hipotesis dan hanya menggunakan SEM untuk menambah tepi, kami juga menguji SEM di bawah kes penggunaan yang diandaikan ini: kami memulakan graf (dihipotesiskan) dengan memadamkan setiap tepi tunggal dan setiap pasangan tepi daripada graf "standard emas" , dan kemudian menguji sama ada SEM boleh memulihkan tepi yang dipadamkan selepas tidak lebih daripada lima lelaran penambahan tepi. Kami memilih lima dalam kajian ini kerana lebih daripada lima kali penambahan tepi akan menghasilkan graf dengan ingatan yang rendah.
metrik penilaian. Untuk menilai prestasi kaedah, kami mentakrifkan metrik penilaian berikut. Tepi adalah betul, jika dan hanya jika sisi yang sama wujud dalam graf "standard emas" dan orientasi tepi itu bertepatan dengan orientasi dalam graf "standard emas"; tepi adalah separuh betul, jika dan hanya jika kelebihan yang sama wujud dalam graf "standard emas" dan orientasinya tidak bercanggah dengan orientasi sebenar tepi dalam graf "standard emas"; Dan akhirnya, tepi tidak betul jika tepi tidak wujud dalam graf "standard emas" atau jika ia wujud tetapi orientasinya adalah bertentangan dengan orientasi sebenar.
Kami akan membentangkan metrik berikut:
1. Bilangan tepi betul, separuh betul, salah
2. Ketepatan: bahagian tepi betul atau separuh betul ke atas semua tepi yang dilaporkan oleh algoritma
3. Ingat: perkadaran tepi dalam graf "standard emas" yang betul atau separa betul dilaporkan
4. Kadar kejadian: peratusan kedekatan ditunjukkan dalam hasil larian 100 bootstrap
Keputusan
kajian penemuan sebab musabab. Struktur kausal yang ditemui yang dihasilkan oleh algoritma SEM, FCI dan FGES merentas tiga darjah "pengetahuan" terdahulu ditunjukkan dalam bahagian ini. Mekanisme di sebalik tabir kesilapan tipikal akan dikaji lebih lanjut dalam bahagian perbincangan.
Eksperimen 1: Tanpa pengetahuan latar belakang. Dalam Rajah 3, kami membentangkan tepi dengan sekurang-kurangnya 80 peratus kadar kejadian dalam 100 sampel bootstrap (nombor Te terletak berhampiran setiap tepi). Tepi yang tiada dalam graf piawai emas diwarnakan dengan merah. Nombor di sebelah kanan setiap graf ialah ketepatan, ingatan semula dan bilangan tepi yang betul, separa betul dan salah yang dipuratakan pada 100 sampel bootstrap. Untuk memudahkan perbandingan langsung, pembolehubah dibentangkan hampir sama: pembolehubah yang sama menduduki lokasi relatif yang sama dalam ketiga-tiga graf. SEM hanya dapat mendapatkan dua tepi yang betul daripada graf "standard emas" (dengan purata ketepatan 0.24 dan mengingat semula 0.30), manakala FCI dan FGES menemui 4 daripada 8 tepi dengan betul atau separuh betul (ketepatan 0.24 dan 0.44, ingat semula 0.46 dan 0.6 yang sepadan). Kedua-dua FCI dan FGES berjaya memulihkan hubungan sebab akibat antara pembolehubah genetik APOE41 dengan ABETA, ABETA dengan FDG, dan FDG, PTAU dengan DX. Walau bagaimanapun, algoritma gagal untuk menentukan arah tuju beberapa perhubungan. Kami juga memerhatikan bahawa ketiga-tiga algoritma melaporkan tepi daripada biomarker kepada pembolehubah demografi yang sememangnya ralat (cth ABETA menyebabkan APOE42 dalam graf FCI). Adalah penting untuk ambil perhatian bahawa beberapa hubungan yang mantap seperti umur dan amiloid serta pendidikan dan diagnosis tidak ditemui dalam mana-mana graf yang tidak mempunyai pengetahuan latar belakang.
Eksperimen 2: Penambahan pengetahuan latar belakang remeh. Rajah 4 membentangkan struktur kausal yang ditemui oleh tiga algoritma yang menggabungkan pengetahuan latar belakang yang remeh: pembolehubah demografi tidak boleh disebabkan oleh pembolehubah demografi lain mahupun oleh penanda bio (contohnya umur peserta tidak dipengaruhi oleh pendidikan atau tahap ABETA). Struktur Rajah 4 adalah serupa dengan Rajah 3.
Walaupun semua kaedah membuat beberapa kesilapan, terdapat peningkatan yang ketara apabila maklumat latar belakang remeh ditambah. Beberapa sebab yang tidak betul yang ditemui oleh SEM sebenarnya adalah hubungan sebab akibat tidak langsung dalam "standard emas". Sebagai contoh, kesan daripada APOE42 kepada DX ialah kesan tidak langsung yang mengalir melalui ABETA dalam graf 'standard emas'. Ketiga-tiga algoritma menemui kelebihan ABETA →DX. Walaupun ia bukan kesan sebab langsung dalam graf "standard emas" kami, ABETA ialah punca biasa pengurangan FDG serta peningkatan PTAU dan kedua-dua FDG dan PTAU membawa kepada DX. Oleh itu, kesan ABETA dan DX boleh dijangkakan. Kedua-dua FCI dan FGES melaporkan kelebihan terarah palsu antara PTAU dan DX. Kita akan melihat ralat ini diperbetulkan dengan menggunakan data membujur. Algoritma FCI juga melaporkan pengacau yang tidak terukur antara PTAU dan DX dengan FDG, yang merupakan hipotesis menarik yang memerlukan kajian lanjut. Antara tiga algoritma, SEM mencapai prestasi terendah (Precision 0.31, ingat semula 0.39) manakala FCI dan FGES mencapai prestasi yang lebih tinggi dan jauh lebih tinggi (FCI: 0.42 precision dan 0.55 mengingat semula; FGES {{10}}.71 ketepatan dan 0.68 mengingat semula).
Eksperimen 3: Penambahan data membujur dan pengetahuan latar belakang remeh. Rajah 5 menunjukkan sisi yang paling kerap ditemui oleh ketiga-tiga algoritma dan metrik prestasinya. Susun atur graf adalah berbeza daripada Rajah sebelumnya kerana ia dibina pada set data membujur. Semua nod yang dikaitkan dengan biomarker atau diagnosis muncul dua kali: sekali dengan nilai garis dasarnya (ditandakan dengan akhiran '0.0') dan sekali pada 24 bulan (ditandakan dengan '0. akhiran 24'). Kebanyakan statistik bertambah baik berbanding keputusan sebelumnya dan FGES memulihkan graf dengan hanya satu tepi yang salah.
Prestasi algoritma SEM berada di belakang dua lagi algoritma penemuan penyebab khusus. Dalam sesetengah larian bootstrap, SEM terlepas kesan langsung antara ukuran membujur biomarker yang sama (cth. anggaran kebarangkalian SEM menemui tepi ABETA.{{0}} →ABETA.24 ialah 0.47 di mana FCI dan FGES sentiasa memasukkan kelebihan ini).
Algoritma FCI seterusnya mengenal pasti bahawa PTAU pada lawatan awal mempunyai kesan ke atas diagnosis (AD) pada 24 bulan. Dalam erti kata lain, PTAU mungkin mempunyai kesan tertinggal pada diagnosis AD yang merupakan hipotesis yang sangat munasabah. Kami juga mendapati bahawa UMUR dan PENDIDIKAN membawa kepada FDG dan diagnosis yang berbeza pada lawatan pertama, tetapi tidak terus kepada penilaian pada 24 bulan (selepas melaraskan penilaian pada lawatan awal).
Algoritma FGES menggabungkan data membujur dan berjaya menemui kelebihan FDG hingga DX. Ia juga mengalih keluar tepi yang salah daripada DX ke PTAU. Tambahan pula, dengan data membujur, tepi yang tidak terarah sebelum ini yang dikenal pasti oleh FGES telah diarahkan tanpa menjejaskan ketepatan dan penarikan semula keseluruhan.
S eM-kajian pemulihan.Jadual 2 menunjukkan statistik apabila kami menguji keupayaan SEM untuk memulihkan tepi yang dipadam daripada graf "standard emas". Dalam setiap larian, kami memadamkan satu tepi atau sepasang tepi. "Kadar pemulihan sepenuhnya" mewakili peratusan larian di mana SEM berjaya memulihkan sepenuhnya tepi yang dipadamkan. Lajur "ketepatan" dan "ingat semula" ditakrifkan dengan cara yang sama seperti dalam percubaan sebelumnya. Seperti yang dapat kita lihat daripada Jadual 2, apabila kita mengeluarkan hanya satu tepi, kadar pemulihan adalah sangat rendah (12.5 peratus). Apabila kami mengalih keluar dua tepi daripada graf "standard emas", SEM tidak dapat memulihkan graf sebenar.
Perbincangan
Dalam kajian ini, kami membandingkan tiga metodologi berbeza untuk mencipta semula struktur sebab-sebab kebenaran asas yang diketahui berdasarkan set data pemerhatian menggunakan tiga darjah "pengetahuan" yang berbeza. Kami menggunakanPenyakit Alzheimerdata daripada ADNI yang merupakan set data boleh diakses secara terbuka yang dicirikan dengan baik. Sejak hubungan antara biomarker dan diagnosis dalamPenyakit Alzheimerdifahami dengan baik, kami bermula dengan struktur kausa "standard emas" berdasarkan kesusasteraan sedia ada. Sepuluh, kami menggunakan tiga algoritma untuk menemui struktur penyebab ini daripada data. Kerja ini menyerlahkan ralat biasa yang dibuat oleh algoritma yang berbeza dan menawarkan kami idea dan cadangan untuk mengelakkan ralat ini. Pada akhirnya, garis panduan terperinci tentang cara algoritma penemuan sebab boleh digunakan untuk menemui hubungan sebab-akibat berkualiti tinggi telah disediakan.
Setiap daripada tiga algoritma yang digunakan dalam kerja ini mewakili kelas algoritma dengan ciri khususnya. Dua daripada algoritma, FCI dan FGES, adalah algoritma penemuan sebab akibat khusus, manakala yang ketiga, SEM, direka terutamanya sebagai alat pengesahan. Algoritma penemuan penyebab yang berdedikasi mengatasi SEM dalam ketiga-tiga darjah pengetahuan latar belakang. Ini tidak menghairankan, kerana SEM tidak direka khusus untuk menemui struktur kausal; statistik yang dilaporkan oleh SEM hanya menunjukkan kemungkinan pelarasan kepada struktur sebab akibat yang ditentukan pengguna a priori. Apa yang mengejutkan ialah sejauh mana FGES mengatasi SEM, kerana kedua-dua FGES dan SEM mengoptimumkan kriteria yang sama, iaitu BIC. Perbezaan utama antara FGES dan SEM ialah skala ruang carian asas: FGES mempertimbangkan tatasusunan graf yang lebih luas, semua graf yang mempunyai struktur pergantungan yang sama (set perhubungan kebebasan bersyarat yang sama antara pembolehubah). Daripada percubaan pemulihan SEM, kami juga mendapati bahawa cadangan SEM untuk menambah tepi secara amnya tidak boleh dipercayai. Tepi ini mungkin memaksimumkan BIC dalam ruang carian terhad SEM, tetapi ini bukanlah tepi optimum keseluruhan: FGES, dengan ruang carian yang lebih besar, berjaya (hampir sempurna) memulihkan graf "standard emas".
Dengan FCI dan FGES mempunyai ruang carian yang serupa, perbezaan utama antara mereka terletak pada algoritma carian mereka. Prestasi algoritma berasaskan skor FGES adalah lebih tinggi dan lebih stabil daripada algoritma berasaskan kekangan FCI dalam kajian kami. Pembuatan keputusan FCI dipengaruhi oleh ujian kebebasan yang salah yang diperkenalkan oleh bias pemilihan atau artifak data. Kesilapan ini disebarkan ke bahagian lain graf melalui penjanaan struktur "V" atau "Y" yang salah dan akhirnya menyebabkan kerosakan pada sebahagian besar graf. Sebaliknya, algoritma berasaskan skor mempertimbangkan kemungkinan struktur global semasa membuat keputusan tempatan; jadi, ralat ini kekal setempat. Ini menjelaskan mengapa struktur FGES yang ditemui sebelum atau selepas menambah pengetahuan trivia adalah lebih konsisten. FCI mempunyai kelebihan kerana dapat mengendurkan andaian tipikal tiada pengacau yang tidak terukur. Kelonggaran ini boleh berguna apabila sama ada mengenal pasti pengacau yang tidak terukur atau membiayai perhubungan sebab yang tidak dikelirukan adalah penting. Dalam kajian kami, FCI mendapati bahawa perhubungan daripada ABETA kepada FDG tidak dikelirukan dan pengacau yang tidak diukur mungkin wujud antara FDG, DX (Rajah 4-FCI)
Kami menyiasat lagi kesilapan yang dilakukan oleh FCI dan FGES. Kami mengumpulkan kesilapan ini kepada tiga kategori dan menerangkan punca dan penyelesaiannya dalam Jadual 3.
1. Ralat jenis pertama berlaku apabila artifak dalam data mendorong tepi yang salah. Sebagai contoh, FCI melaporkan kelebihan antara EDU dan SEX (Rajah 3-FCI), kerana, dalam sampel kami, tahap pendidikan purata peserta lelaki adalah lebih tinggi. Mengelakkan bahagian tepi yang salah adalah penting kerana ia berpotensi mencipta struktur "V" atau "Y" yang salah yang menjejaskan langkah penemuan sebab yang selebihnya. Menambah pengetahuan latar belakang yang remeh boleh menyelesaikan masalah ini dengan menghalang algoritma daripada menganggap perkaitan sebagai penyebab.
2. Apabila pengetahuan latar belakang yang diterima secara universal tidak tersedia, mengimbangi artifak data adalah lebih sukar dan boleh mempunyai kesan hiliran yang jauh. Contohnya, struktur APOE42-PTAU-FDG telah disimpulkan sebagai struktur "V" (APOE42 →PTAU ←FDG) dalam beberapa larian bootstrap. Ralat ini adalah hasil daripada satu kebebasan yang disimpulkan secara salah antara APOE42 dan FDG daripada data sampel. Ralat ini disebarkan melalui tiga perkaitan antara (1) APOE42 dan PTAU, (2) PTAU dan FDG, dan (3) APOE42 dan FDG bersyarat pada PTAU, yang membawa kepada struktur "V" antara ketiga-tiganya. Kita tidak boleh menghalang kelebihan ini menggunakan pengetahuan latar belakang melainkan kita mengetahui hubungan kebebasan bersyarat antara APOE42 dan FDG terlebih dahulu. Penggunaan data membujur membantu membetulkan kesilapan ini; seperti yang dapat kita lihat dalam Rajah. 5-FCI, substruktur telah diperbetulkan apabila data membujur digunakan.
3. Walaupun data longitudinal menyediakan penyelesaian kepada beberapa masalah, keperluan pemerhatian berulang boleh mengekang saiz sampel dan memperkenalkan beberapa ralatnya sendiri. Sebagai contoh, FCI menemui kemungkinan hubungan tertinggal antara PTAU pada masa 0 dan DX pada bulan 24 (Rajah 5-FCI), walau bagaimanapun, hubungan yang sama tidak diperhatikan dalam keputusan daripada FGES (Gamb. 5-FGES)–mungkin disebabkan saiz sampel yang kecil.
Dalam kajian membujur, struktur tempatan merentas titik masa tidak dijamin sama. Contohnya, dalam graf yang ditemui oleh FGES, ABETA.{{0}} menyebabkan PTAU.0 tetapi ABETA.24 tidak menyebabkan PTAU.24. Sebabnya ialah ABETA.0 ialah induk biasa ABETA.24 dan PTAU.0. PTAU.24 adalah bebas bersyarat daripada ABETA.24 yang diberikan sama ada ABETA.{{10}} atau PTAU.0. Hubungan bebas bersyarat ini membayangkan bahawa dengan adanya ABETA.0 atau PTAU.0, ABETA.24 tidak diperlukan untuk menjelaskan variasi dalam PTAU.24.
Walaupun graf akhir yang dipelajari daripada data pemerhatian sepadan dengan graf "standard emas" rapat, kesimpulan kami masih bergantung pada ketepatan "standard emas". Secara umumnya, kami mempunyai keyakinan tinggi terhadap graf "standard emas" kerana mekanisme biologi di sebalik lata biomarker AD difahami dengan baik dan FGES berjaya menemui "standard emas" dengan hampir sempurna. Walau bagaimanapun, kemungkinan besar FDG dan PTAU hanya menerangkan sebahagian daripada kesan daripada ABETA ke atas diagnosis AD; sebab langsung daripada ABETA pada DX mungkin wujud. Walaupun kami mengesyorkan data membujur, mengumpul data secara membujur selalunya memerlukan kos yang lazimnya menghasilkan saiz sampel yang lebih kecil. Saiz sampel yang kecil merendahkan kuasa statistik dalam algoritma penemuan sebab yang merupakan pertukaran. Kami cuba mengurangkan saiz sampel sebanyak 50 peratus dan 75 peratus dan menjalankan analisis yang sama. Apabila kami mengurangkan saiz sampel sebanyak 50 peratus , jumlah bilangan tepi yang ditemui merentas 100 lelaran bootstrap telah dikurangkan. Walau bagaimanapun, tepi yang ditemui secara konsisten pada sampel penuh secara konsisten ditemui pada sampel yang dikurangkan juga. Kami mencapai ketepatan dan ingatan yang sama. Apabila kami mengurangkan lagi saiz sampel (sebanyak 75 peratus ), jumlah bilangan tepi dikurangkan lagi. Walaupun tepi yang paling kerap ditemui terus ditemui, bilangan "tepi hingar", tepi yang ditemui hanya dalam beberapa lelaran bootstrap, meningkat.
Kesimpulannya, algoritma penemuan kausal yang berdedikasi mengatasi SEM dalam menemui struktur kausal. Dalam analisis data dunia sebenar, kualiti data memberi kesan kepada ketepatan struktur yang ditemui. Menggabungkan pengetahuan sedia ada dan menggunakan data membujur boleh meningkatkan hasil yang ditemui dengan menghalang algoritma daripada membuat beberapa kemungkinan kesilapan.
1. Ralat jenis pertama berlaku apabila artifak dalam data mendorong tepi yang salah. Sebagai contoh, FCI melaporkan kelebihan antara EDU dan SEX (Rajah 3-FCI), kerana, dalam sampel kami, tahap pendidikan purata peserta lelaki adalah lebih tinggi. Mengelakkan bahagian tepi yang salah adalah penting kerana ia berpotensi mencipta struktur "V" atau "Y" yang salah yang menjejaskan langkah penemuan sebab yang selebihnya. Menambah pengetahuan latar belakang yang remeh boleh menyelesaikan masalah ini dengan menghalang algoritma daripada menganggap perkaitan sebagai penyebab.
2. Apabila pengetahuan latar belakang yang diterima secara universal tidak tersedia, mengimbangi artifak data adalah lebih sukar dan boleh mempunyai kesan hiliran yang jauh. Contohnya, struktur APOE42-PTAU-FDG telah disimpulkan sebagai struktur "V" (APOE42 →PTAU ←FDG) dalam beberapa larian bootstrap. Ralat ini adalah hasil daripada satu kebebasan yang disimpulkan secara salah antara APOE42 dan FDG daripada data sampel. Ralat ini disebarkan melalui tiga perkaitan antara (1) APOE42 dan PTAU, (2) PTAU dan FDG, dan (3) APOE42 dan FDG bersyarat pada PTAU, yang membawa kepada struktur "V" antara ketiga-tiganya. Kita tidak boleh menghalang kelebihan ini menggunakan pengetahuan latar belakang melainkan kita mengetahui hubungan kebebasan bersyarat antara APOE42 dan FDG terlebih dahulu. Penggunaan data membujur membantu membetulkan kesilapan ini; seperti yang dapat kita lihat dalam Rajah. 5-FCI, substruktur telah diperbetulkan apabila data membujur digunakan.
3. Walaupun data longitudinal menyediakan penyelesaian kepada beberapa masalah, keperluan pemerhatian berulang boleh mengekang saiz sampel dan memperkenalkan beberapa ralatnya sendiri. Sebagai contoh, FCI menemui kemungkinan hubungan tertinggal antara PTAU pada masa 0 dan DX pada bulan 24 (Rajah 5-FCI), walau bagaimanapun, hubungan yang sama tidak diperhatikan dalam keputusan daripada FGES (Gamb. 5-FGES)–mungkin disebabkan saiz sampel yang kecil.
Dalam kajian membujur, struktur tempatan merentasi titik masa tidak dijamin sama. Contohnya, dalam graf yang ditemui oleh FGES, ABETA.{{0}} menyebabkan PTAU.0 tetapi ABETA.24 tidak menyebabkan PTAU.24. Sebabnya ialah ABETA.0 ialah induk biasa ABETA.24 dan PTAU.0. PTAU.24 adalah bebas bersyarat daripada ABETA.24 yang diberikan sama ada ABETA.{{10}} atau PTAU.0. Hubungan bebas bersyarat ini membayangkan bahawa dengan adanya ABETA.0 atau PTAU.0, ABETA.24 tidak diperlukan untuk menjelaskan variasi dalam PTAU.24.
Walaupun graf akhir yang dipelajari daripada data pemerhatian sepadan dengan graf "standard emas" rapat, kesimpulan kami masih bergantung pada ketepatan "standard emas". Secara umumnya, kami mempunyai keyakinan tinggi terhadap graf "standard emas" kerana mekanisme biologi di sebalik lata biomarker AD difahami dengan baik dan FGES berjaya menemui "standard emas" dengan hampir sempurna. Walau bagaimanapun, kemungkinan besar FDG dan PTAU hanya menerangkan sebahagian daripada kesan daripada ABETA ke atas diagnosis AD; sebab langsung daripada ABETA pada DX mungkin wujud. Walaupun kami mengesyorkan data membujur, mengumpul data secara membujur selalunya memerlukan kos yang lazimnya menghasilkan saiz sampel yang lebih kecil. Saiz sampel yang kecil merendahkan kuasa statistik dalam algoritma penemuan sebab yang merupakan pertukaran. Kami cuba mengurangkan saiz sampel sebanyak 50 peratus dan 75 peratus dan menjalankan analisis yang sama. Apabila kami mengurangkan saiz sampel sebanyak 50 peratus , jumlah bilangan tepi yang ditemui merentas 100 lelaran bootstrap telah dikurangkan. Walau bagaimanapun, tepi yang ditemui secara konsisten pada sampel penuh secara konsisten ditemui pada sampel yang dikurangkan juga. Kami mencapai ketepatan dan ingatan yang sama. Apabila kami mengurangkan lagi saiz sampel (sebanyak 75 peratus ), jumlah bilangan tepi dikurangkan lagi. Walaupun tepi yang paling kerap ditemui terus ditemui, bilangan "tepi hingar", tepi yang ditemui hanya dalam beberapa lelaran bootstrap, meningkat.
Kesimpulannya, algoritma penemuan kausal yang berdedikasi mengatasi SEM dalam menemui struktur kausal. Dalam analisis data dunia sebenar, kualiti data memberi kesan kepada ketepatan struktur yang ditemui. Menggabungkan pengetahuan sedia ada dan menggunakan data membujur boleh meningkatkan hasil yang ditemui dengan menghalang algoritma daripada membuat beberapa kemungkinan kesilapan.

Rujukan
1. Beam, AL & Kohane, IS Big Data dan Pembelajaran Mesin dalam Penjagaan KesihatanBig Data dan Pembelajaran Mesin dalam Penjagaan KesihatanBig Data dan Pembelajaran Mesin dalam Penjagaan Kesihatan. JAMA 319, 1317–1318, https://doi.org/10.1001/jama.2017.18391 (2018).
2. Murdoch, TB & Detsky, AS Te Penggunaan Data Besar yang Tidak Dapat Dielakkan untuk Penjagaan KesihatanTe Penggunaan Data Besar yang Tidak Dapat Dielakkan untuk Penjagaan Kesihatan. JAMA 309, 1351–1352.
3. Trister, AD, Buist, DSM & Lee, CI Adakah Pembelajaran Mesin akan Mengimbangi Keseimbangan dalam Saringan Kanser Payudara? Adakah Pembelajaran Mesin Akan Mengimbangi Keseimbangan dalam Saringan Kanser Payudara? Adakah Pembelajaran Mesin akan Mengimbangi Keseimbangan dalam Pemeriksaan Kanser Payudara? JAMA Onkologi 3, 1463–1464.
4. Rogers, MB Tere Tiada Esok untuk ESOK. ALZFORUM.
5. Arvanitakis, Z. et al. Diabetes berkaitan dengan infarksi serebrum tetapi tidak dengan patologi AD pada orang yang lebih tua. Neurologi 67, 1960–1965.
6. Vemuri, P. et al. Umur, kesihatan vaskular dan biomarker penyakit Alzheimer dalam sampel warga emas. Ann. Neurol. 82, 706–718.
7. Jack, CR Jr. et al. Menjejaki proses patofisiologi dalam penyakit Alzheimer: model hipotesis yang dikemas kini bagi biomarker dinamik. Neurol Lancet. 12, 207–216, https://doi.org/10.1016/s1474-4422(12)70291-0 (2013).
8. Pearl, J. Kausalitas: Model, Penaakulan, dan Inferens. Vol. 64 (Cambridge University Press, 2000).
9. Spirtes, P., Meek, C. & Richardson, TS Inferens Penyebab dalam Kehadiran Pembolehubah Terpendam dan Bias Pemilihan. CoRR abs/1302.4983(2013).
10. Ramsey, JD Meningkatkan Pencarian Kesetaraan Tamak untuk Pembolehubah Berterusan. CoRR abs/1507.07749 (2015).
11. Chickering, Pengenalpastian Struktur Optimum DM Dengan Carian Tamak. Jurnal Penyelidikan Pembelajaran Mesin 3, 507–554 (2002).
12. Mani, S., Spirtes, P. & Cooper, GF Kajian teori struktur Y untuk penemuan sebab akibat. CoRR abs/1206.6853 (2012).
13. Spirtes, P., Clark, G. & Scheines, R. Penyebab, Ramalan dan Carian. (Te MIT Press, 2000).
14. Schwarz, G. Menganggar Dimensi Model. The Annals of Statistics 6, 461–464.
15. Meek, C. Model Grafik: Memilih model sebab dan statistik, (1997).
16. Kline, RB Prinsip dan amalan pemodelan persamaan struktur, 3rd ed. 265–295 (Guilford Press, 2011).
17. Heckerman, D., Meek, C. & Cooper, G. Dalam Inovasi dalam Pembelajaran Mesin: Teori dan Aplikasi (eds. Dawn E. Holmes & Lakhmi C. Jain) 1–28 (Springer Berlin Heidelberg, 2006).
18. Rosseel, Y. lavaan: Pakej R untuk Pemodelan Persamaan Struktur. Journal of Statistical Sofware 48, 36, https://doi.org/10.18637/ jss.v048.i02 (2012).
19. Weiner, MW et al. Kesan Inisiatif Neuroimaging Penyakit Alzheimer, 2004 hingga 2014. Alzheimer & demensia: jurnal Persatuan Alzheimer 11, 865–884.
20. Mishra, S. et al. Pengimejan otak membujur dalam penyakit Alzheimer praklinikal: kesan genotip APOE epsilon4. Otak 141, 1828–1839.